addyosmani/agent-skills 裝進專案之後,OpenCode 的免費模型不會自己去用它。團隊用兩個寫程式任務、三個免費模型跑了 18 次。沒點名的 6 次,skill 呼叫次數是 0。在需求句寫出 skill 名稱的 6 次全部照著做:先寫測試、先重現錯誤。修出來的金額計算,在 20,000 個價格的驗算裡沒有一個錯。
實測環境:Debian 12(node:22-bookworm Docker 容器)、OpenCode 1.19.5、Node.js 22.23.4、agent-skills commit 301b02b(2026-11-01),2026-11-12
我會裝,但只在需要它的時候點名。新功能要它寫測試,我會在需求句寫「請使用 test-driven-development」。修既有程式的錯,我會點名 debugging-and-error-recovery。只是裝著、等代理自己挑,這次測試裡沒有發生過,還讓每一步多帶約 3,000 tokens。專案很小、改動一句話就說得完的工作,我不會為了它多花兩三倍的 token。
先說結果:差別出在需求句有沒有點名
agent-skills 是 Addy Osmani 整理的工程流程 skill 集合,MIT 授權。這次測的版本有 25 個 skill,從規格、測試、除錯一路到上線都有。每個 skill 是一份 SKILL.md,README 的說法是把資深工程師的工作流程與品質關卡寫下來,讓代理照著做。
團隊設計了三個條件,每個條件用同一個起始專案、同一句需求:
| 條件 | 做法 | 兩個任務合計呼叫 skill 的次數 |
|---|---|---|
| 沒裝 | 專案裡沒有任何 skill | 不適用 |
| 裝了沒點名 | npx skills add 裝好 25 個,需求句不變 |
0 / 6 次 |
| 點名 | 一樣裝好,需求句最前面加「請使用 ○○ skill 來做這件事」 | 6 / 6 次 |
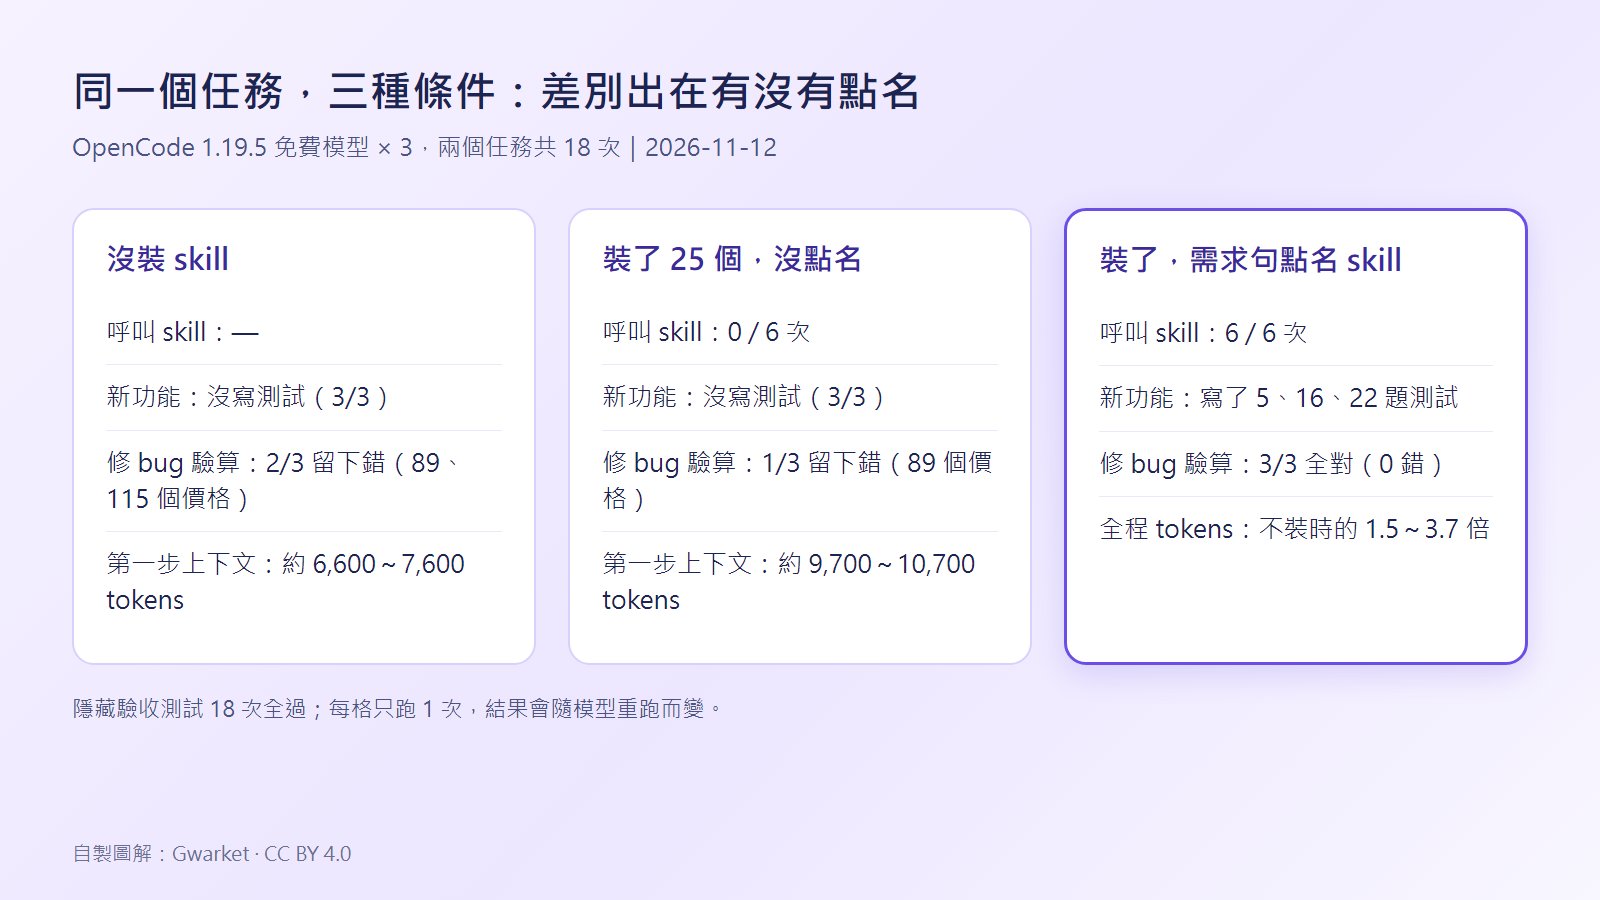
隱藏驗收測試在執行結束後才放進容器,代理看不到,18 次全部通過。三種條件的差別出現在代理有沒有留下自己的測試,以及修好的程式碼經不經得起更大範圍的驗算。
25 個 skill 裝進去之後,代理實際看到什麼
在 OpenCode 的執行紀錄裡,skill 是一個叫 skill 的工具,代理呼叫它才會套用某一個 skill。用 opencode debug skill 可以看到它讀到了什麼:
skills from .agents/skills: 25
built-in: 1
三個模型第一步的上下文大小,沒裝時是 6,615 到 7,640 tokens,裝了之後變成 9,671 到 10,715 tokens,6 次都沒有呼叫 skill。25 份 SKILL.md 合計 7,335 行,多出來的約 3,000 tokens 遠小於全文,比較像是 skill 清單與描述。免費模型的費用欄位是 0,換成付費 API 時這筆就會出現在帳單上。
套件裡有一個 using-agent-skills,描述寫著「Use when starting a session」,用來決定要套哪個 skill。團隊測試的 6 次「裝了沒點名」裡,沒有一次呼叫它。
怎麼裝到 OpenCode:指令與確認方法
在專案根目錄執行:
npx -y skills add addyosmani/agent-skills --agent opencode -y
13 次安裝的輸出都是 Installed 25 skills。檔案放在專案的 .agents/skills/,另外產生 skills-lock.json,記下每個 skill 的來源路徑與雜湊值。安裝結尾有一行提醒:Review skills before use; they run with full agent permissions.
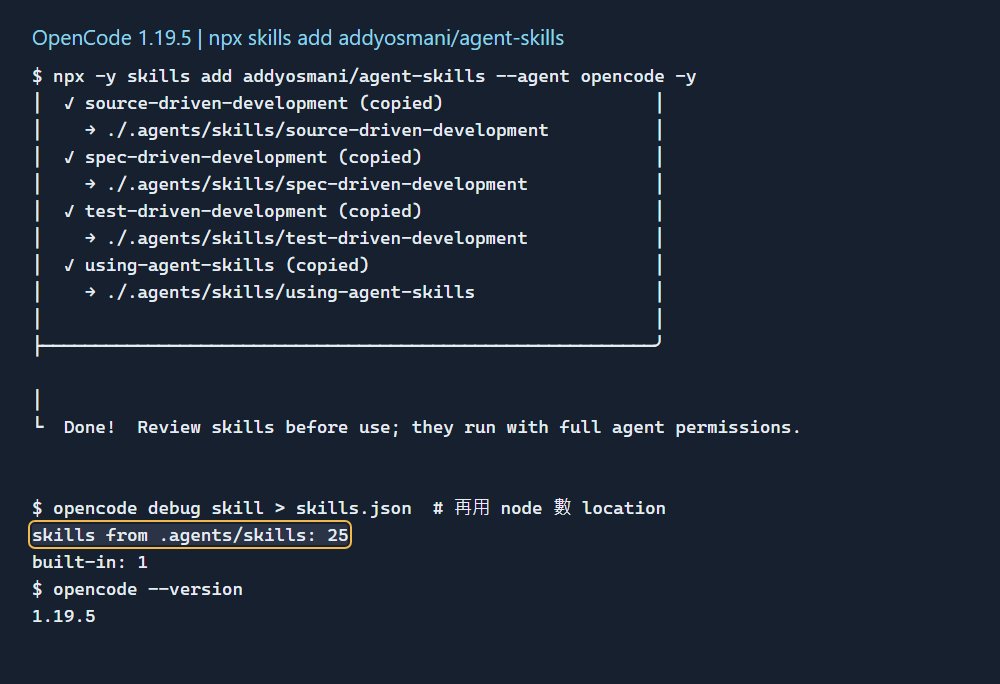
第一次用 opencode debug skill | grep -c ".agents/skills" 去數,結果是 11。把輸出先寫進檔案再讀,才是 25。管線輸出在程序結束前被截斷了。
任務 1:從空資料夾寫一個新函式
需求是在 src/dateRange.js 實作 parseDateRange。輸入「YYYY-MM-DD..YYYY-MM-DD」,回傳起訖字串與含頭尾的天數。格式錯、日期不存在、結束早於開始,都要丟錯。起始專案沒有任何測試檔。隱藏測試有 10 題,含閏年、跨年、2026-02-30、2027-02-29 和斜線格式。
| 模型 | 條件 | 秒數 | 隱藏測試 | 呼叫的 skill | 結束時專案裡的測試 |
|---|---|---|---|---|---|
| beam-free | 沒裝 | 18 | 10/10 | — | 0 題 |
| beam-free | 裝了沒點名 | 42 | 10/10 | — | 0 題 |
| beam-free | 點名 | 37 | 10/10 | test-driven-development | 5 題 |
| deepseek-v4.1-flash-free | 沒裝 | 67 | 10/10 | — | 0 題 |
| deepseek-v4.1-flash-free | 裝了沒點名 | 15 | 10/10 | — | 0 題 |
| deepseek-v4.1-flash-free | 點名 | 114 | 10/10 | test-driven-development | 22 題 |
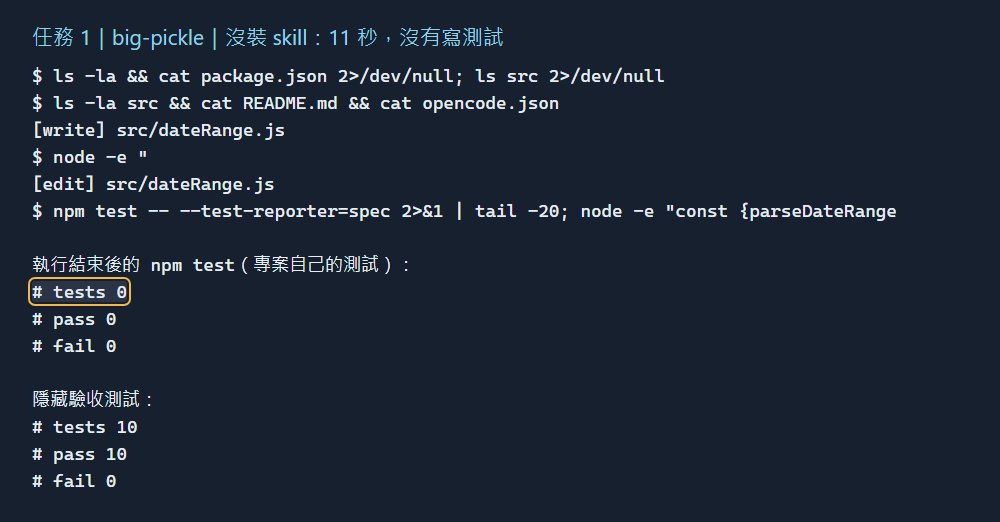
| big-pickle | 沒裝 | 11 | 10/10 | — | 0 題 |
| big-pickle | 裝了沒點名 | 18 | 10/10 | — | 0 題 |
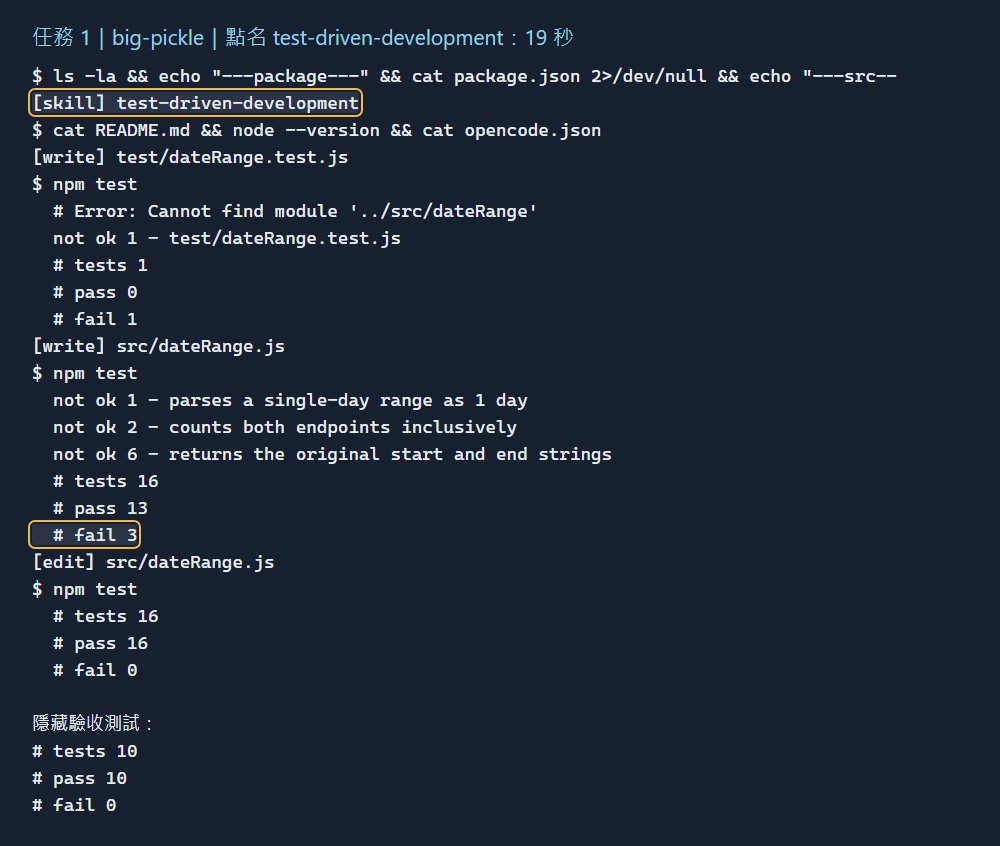
| big-pickle | 點名 | 19 | 10/10 | test-driven-development | 16 題 |
三個模型不點名時都寫對了,但 6 次都沒有留下測試檔。它們用 node -e 臨時跑幾組輸入確認,其中兩次在回覆裡寫明 npm test 目前是 0 個測試。
點名 test-driven-development 之後,流程變成先寫測試、看它失敗、再寫實作。big-pickle 的第一版實作讓自己的 16 題測試失敗 3 題,錯在單日區間與回傳的原字串;改完才 16 題全過。它最後的回覆寫著:「過程中測試抓到並修正了一個 slice 位移 bug。」beam-free 第一版檔案有語法錯誤,npm test 印出 SyntaxError: Invalid or unexpected token,它讀檔修正後 5 題通過。
這個任務的正確率沒有差。差別是點名之後專案裡多了 5 到 22 題可以重跑的測試,下一個人改這個函式時有東西可以驗。代價是 token:三個模型點名時的全程處理量是不裝時的 2.5 到 3.7 倍。
任務 2:修既有專案的兩個錯
第二個任務比較接近日常工作。起始專案已經有 src/cart.js 和 2 題測試,需求句轉述客服回報的兩個錯。一是買 40 元商品用 MINUS50 折扣碼,結帳變成 -10 元。二是買 1.15 元商品用 SAVE10 打九折,顯示 1.03,應該是 1.04。第二個錯的原因在浮點數:Node.js 印 1.15 * 0.9 會顯示 1.035,乘 100 卻是 103.49999999999999,四捨五入就掉到 103。
九次都修好了兩個回報的案例,隱藏測試 8 題全過。不點名時,deepseek 和 big-pickle 也自己補了兩題回歸測試,任務 1 從空資料夾開始時它們都沒有這樣做。beam-free 不點名的兩次沒有加測試。
點名 debugging-and-error-recovery 的三次,第一個動作都是呼叫 skill,接著在改程式碼之前先重現兩個錯。deepseek 跑了一段指令,印出:
MINUS50 40: -10
SAVE10 1.15: 1.03
raw: 1.035 103.49999999999999
big-pickle 則把五種四捨五入寫法並排跑過,看哪幾種會把 1.035 進到 1.04,再挑一種。
修好之後再驗一次:隱藏測試沒抓到的錯
隱藏測試只驗回報的那一個價格。團隊另外把九種修法套回原始程式碼,放進斷網的容器。從 0.01 到 200.00 元,每一分錢跑一次九折,再和以「分」為單位的精確計算比對,一共 20,000 個價格。
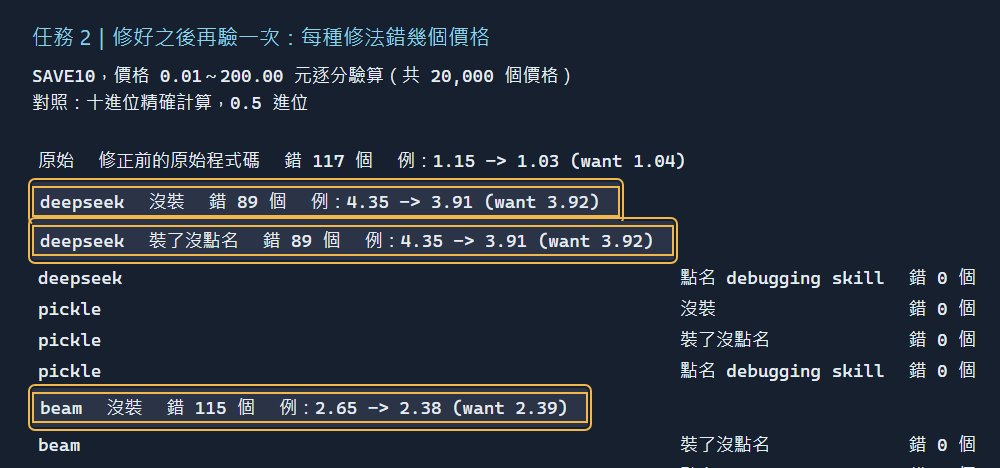
| 修法 | 錯幾個價格 | 第一個錯的例子 |
|---|---|---|
| 原始程式碼 | 117 | 1.15 元算成 1.03 |
| deepseek 沒裝、裝了沒點名 | 89、89 | 4.35 元算成 3.91,應為 3.92 |
| beam-free 沒裝 | 115 | 2.65 元算成 2.38,應為 2.39 |
| 點名 debugging skill 的三次 | 0、0、0 | — |
| big-pickle 不點名的兩次、beam-free 裝了沒點名 | 0、0、0 | — |
deepseek 不點名時用的是常見的字串位移寫法 Number(Math.round(Number(amount + 'e2')) + 'e-2')。這個寫法對 1.035 有效,遇到 4.35 打九折時金額在記憶體裡已經是 3.9149999…,照樣進錯。beam-free 不點名時在金額上加 Number.EPSILON,這個值太小,金額超過 1 元之後就補不到誤差。點名的三次裡,deepseek 和 big-pickle 讓誤差補償跟著金額放大;beam-free 在金額上加固定的 1e-9,在 200 元以內 0 錯,更大的金額這次沒有驗。
為什麼點名之後才有差:skill 的觸發方式
OpenCode 把 skill 做成一個工具,代理要自己決定什麼時候呼叫。任務 1 不點名的 6 次,代理都是先用 ls、find 看專案內容,接著直接寫程式,中間沒有呼叫 skill。點名之後,三個模型在任務 1 都是第一或第二步就呼叫 skill。
test-driven-development 的 SKILL.md 寫著先寫會失敗的測試,修錯時先用測試重現。debugging-and-error-recovery 列的順序是停下、保留證據、診斷、修根本原因、防止再發生、驗證後才繼續。點名之後三個模型都是先重現或先寫測試,再改程式碼。test-driven-development 的描述寫了「需求沒提到測試」時也要用,但裝了沒點名的那幾次,沒有一次觸發。
這個結果的範圍是 OpenCode 1.19.5。Claude Code 用 plugin 安裝,觸發方式可能不同,要另外驗證。
什麼情況值得裝、什麼情況可以不裝
| 情況 | 建議 |
|---|---|
| 要代理寫新功能,而且希望留下測試 | 裝,點名 test-driven-development |
| 修既有程式的錯,尤其是金額、日期這類有邊界的計算 | 裝,點名 debugging-and-error-recovery |
| 專案已經有測試資料夾,只是小修改 | 可以不點名,這次有 2/3 的模型會自己補回歸測試 |
| 只裝著,期待代理自己挑 | 這次 6 次都沒發生,每一步還多約 3,000 tokens |
| 用付費 API、對 token 敏感 | 只在需要的任務點名;點名時全程 token 是不裝的 1.5 到 3.7 倍 |
如果只想要其中一兩個 skill,skills add 可以用 --skill 指定名稱。團隊試過 --skill test-driven-development,輸出 Installed 1 skill,opencode debug skill 只數到 1 個專案 skill。只裝一個時上下文會多多少,不在這次的量測範圍。
這次沒測到的部分
每個條件每個模型只跑了 1 次。免費模型同一句話重跑結果會變,表格裡的數字是這一次的紀錄,不是平均。秒數是三個模型同時在不同容器跑的,排隊時間會影響,只能看大概。
測試範圍只有 OpenCode 的三個免費模型和兩個被點名的 skill。付費模型、Claude Code 與 Codex 的安裝方式,以及其他 23 個 skill,都在這次範圍外。大型專案、需要多輪來回的任務,結果可能不同。
常見問題
怎麼確認代理這次有沒有用到 skill?
用 opencode run --format json 執行,紀錄裡每個工具呼叫都有 "tool" 欄位。出現 "tool":"skill" 就是有用,state.input.name 是 skill 名稱。
25 個全裝會不會拖慢? 不點名時,裝了的那幾次秒數有快有慢,看不出規律;上下文每一步多約 3,000 tokens 是確定的。
skill 會拿到比代理更多的權限嗎?
安裝程式的提醒是 skill 用代理現有的權限執行。代理能跑 shell,skill 就能叫它跑 shell,所以裝之前先讀過 SKILL.md。
站內相關內容:AI 的 Skill 是什麼、OpenCode 免費模型實測、Skill 推薦清單。
來源:addyosmani/agent-skills(commit 301b02b,2026-11-01)、Addy Osmani 的設計說明,查證 2026-11-12。