從一段 Python 走到一個可重跑的小專案
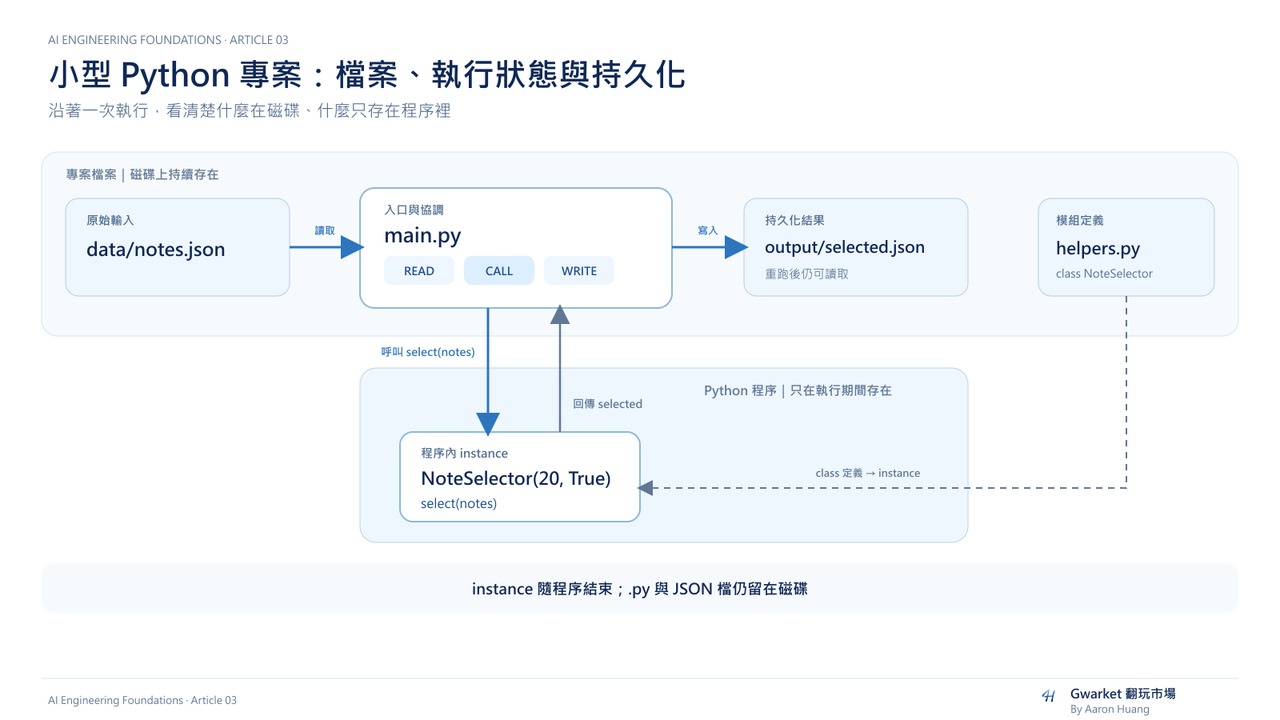
把一段 Python 變成「可重跑的小專案」,最低限度要固定五件事:入口、輸入、處理責任、持久化結果、重跑方式。 檔案變多本身沒有價值;真正有價值的是另一個新程序可以知道從哪裡開始、讀哪份資料、呼叫哪段邏輯、結果寫到哪裡,並照說明得到可預期的結果。
上一篇〈Python 程式怎麼處理資料?〉先建立單一程式裡的資料流;這篇把那條資料流放進兩個 Python 檔案,再加入 JSON 持久化、import、class 與 README。若你連「現在是哪個 Python 在跑、working directory 在哪裡」都還不確定,先回到〈Python 到底在哪裡跑?〉。
本篇只做到:能讀懂、修改並重跑一個 2 個 Python 檔案的小專案。 不進 packaging、部署、Git、HTTP、資料庫或大型架構。
目錄
- 可重跑的小專案,最低要固定哪五件事?
- 程式關掉後,資料怎麼留下?
- main.py 和 helpers.py 怎麼分工?
- import 到底做了什麼?
- class 的狀態為什麼不等於持久化?
- 出錯時,先判斷是哪一層
- README 怎樣才真的能讓別人重跑?
- 怎麼驗收自己真的看懂?
- 停止線與技術來源
可重跑的小專案,最低要固定哪五件事?
先看答案:
| 要固定的事 | 本篇範例 |
|---|---|
| 入口 | main.py |
| 輸入 | data/notes.json |
| 處理責任 | helpers.py 裡的 NoteSelector |
| 持久化結果 | output/selected.json |
| 重跑方式 | README 裡的 Python 版本、必要檔案、指令與預期結果 |
最小結構只有:
note-project/
├── main.py
├── helpers.py
├── data/
│   └── notes.json
├── README.md
└── output/
    └── selected.json   # 成功執行後產生
這裡不先建立 services/、controllers/ 或其他空架構層。只要說不清楚「為什麼需要這個檔案」,就不因為看起來更像大型專案而加入。
程式關掉後,資料怎麼留下?
Python 裡的 list、dict、class instance 都屬於目前程序的記憶體狀態。程序結束後,下一個 Python 不會自動取得那些物件。
要跨程序留下資料,本篇採最直接的方法:寫進磁碟檔案。
| 東西 | 關掉 Python 後 | 本篇用途 |
|---|---|---|
| list / dict / instance | 不會自動保留 | 程序內運算與設定 |
| JSON 檔案 | 仍在磁碟上 | 保存輸入與結果 |
| README | 仍在磁碟上 | 保存重跑條件與步驟 |
資料會經過:
JSON 檔
→ json.load()
→ Python 資料
→ NoteSelector 處理
→ json.dump()
→ 新 JSON 檔
檔案模式也要分清楚:
| 模式 | 核心行為 |
|---|---|
r |
讀取既有檔案 |
w |
開啟既有檔案時先截斷,再進行後續寫入 |
a |
從既有檔案尾端追加 |
所以原始輸入和可重建輸出要分開。用 w 寫結果不是「自動安全替換」,後續寫入若失敗,舊內容不會自己恢復。文字讀寫也明確指定 UTF-8,不假設作業系統預設編碼都一樣。
main.py 和 helpers.py 怎麼分工?
這個教學例子有四筆合成資料:
[
  {"title": "整理 Python 路徑", "minutes": 25, "done": true},
  {"title": "複習 return", "minutes": 10, "done": true},
  {"title": "練習 JSON 讀寫", "minutes": 30, "done": false},
  {"title": "確認 README 重跑", "minutes": 20, "done": true}
]
篩選規則只有兩個:
done = trueminutes >= 20
因此預期留下「整理 Python 路徑」與「確認 README 重跑」。
helpers.py 只負責篩選:
class NoteSelector:
    def __init__(self, min_minutes, done_only=True):
        self.min_minutes = min_minutes
        self.done_only = done_only

    def select(self, notes):
        selected = []
        for note in notes:
            if self.done_only and not note["done"]:
                continue
            if note["minutes"] >= self.min_minutes:
                selected.append({
                    "title": note["title"],
                    "minutes": note["minutes"],
                })
        return selected
正文用一個最小版 main.py 把流程串起來:
import json
from pathlib import Path
from helpers import NoteSelector

ROOT = Path(__file__).resolve().parent
INPUT = ROOT / "data" / "notes.json"
OUTPUT = ROOT / "output" / "selected.json"


def main():
    with INPUT.open("r", encoding="utf-8") as file:
        notes = json.load(file)

    selector = NoteSelector(20, True)
    selected = selector.select(notes)

    OUTPUT.parent.mkdir(parents=True, exist_ok=True)
    with OUTPUT.open("w", encoding="utf-8") as file:
        json.dump(selected, file, ensure_ascii=False, indent=2)

    print(f"read={len(notes)} selected={len(selected)}")


if __name__ == "__main__":
    main()
這個最小版和後面的 __name__ 說明使用同一個 execution model:直接執行 main.py 才呼叫主流程;只做 import main 不會產生輸出。
第一次執行 python main.py 後,不要只看「沒有報錯」。至少確認:
- 顯示
read=4 selected=2。 - 原始
data/notes.json仍是四筆。 output/selected.json只有預測的兩筆。
接著關掉前一個 Python,再開新的程序重新讀 output/selected.json。這一步成功,才直接證明結果真的留在磁碟,而不是只存在前一個程序的變數裡。
import 到底做了什麼?
from helpers import NoteSelector 不等於「把另一個檔案的文字貼進 main.py」。
夠用的心智模型是:
- Python 先找到
helpersmodule。 - module 有自己的 namespace,也就是名稱與物件的對應範圍。
- module 第一次載入時,頂層敘述會被處理。
from helpers import NoteSelector把NoteSelector這個名稱綁到目前 module 可使用的 namespace。
如果寫 import helpers,後面會用 helpers.NoteSelector(...);差別是名稱怎麼進入目前程式,不是 class 變成另一份。
本篇 main.py 最後使用 if __name__ == "__main__": main()。這個 guard 只控制「要不要呼叫主流程」,不是讓整個檔案在 import 時完全停止處理。
遇到「明明有 helpers.py 卻 import 不到」,不要先改 sys.path 或安裝不明套件。先確認啟動位置,再看 helpers.__file__ 指向哪一份檔案。
做一次刻意失敗就夠:先在 note-project 內執行 python -c "import helpers; print(helpers.__file__)",確認載入本專案的檔案;再移到父資料夾執行 python -c "import helpers"。在沒有其他同名 module 的情況下,預期得到 ModuleNotFoundError。回到 note-project 後,同一個 import 應恢復成功。這個「失敗 → 看搜尋位置 → 回到正確位置」就是本篇的 controlled failure,不需要在 README 或驗收段落再重教一次。
class 的狀態為什麼不等於持久化?
NoteSelector 是 class 定義;NoteSelector(20, True) 才建立 instance。
建立 instance 時,Python 會把新物件當成 self 傳給 __init__(),你提供的 20 與 True 則成為這個 instance 的設定。
同一個 class 可以建立:
normal = NoteSelector(20, True)strict = NoteSelector(25, True)
同一份 notes 下,normal 應留下 2 筆,strict 應只留下 1 筆。
呼叫 normal.select(notes) 時,normal 會成為 method 裡的 self,notes 才是你明確傳入的方法資料。
如果寫成 NoteSelector(),必要的 min_minutes 沒有提供,Python 會在呼叫邊界提出 TypeError。最小修正是補上參數,不是重寫 class。
但 normal / strict 的設定仍然只是程序內狀態。關掉 Python 後,它們不會自動被保存;真正跨程序留下來的是磁碟檔案。
出錯時,先判斷是哪一層
不要看到錯誤就全面重寫。先判斷程式在哪一層失敗:
| 現象 | 發生層次 | 先查什麼 | 最小修正 |
|---|---|---|---|
FileNotFoundError |
檔案位置 | traceback 裡實際找的路徑 | 還原檔名或修正路徑 |
| JSON 解碼錯誤 | 檔案格式 | JSON 是否有多餘逗號、缺括號 | 修正 JSON 語法 |
minutes 是 "20" |
資料契約 | 外層是 array 後,再看欄位型別 | 改回整數 |
ModuleNotFoundError |
module 搜尋 | 啟動位置與 helpers.__file__ |
回到正確位置/確認載入來源 |
NoteSelector() 的 TypeError |
呼叫參數 | 缺哪個必要參數 | 補 min_minutes |
另外要留意:如果前一次成功過,後一次卻在讀檔或解析 JSON 時失敗,舊的 output/selected.json 可能還在。舊結果存在,不代表這次成功。 驗證要看這次程序是否成功結束,以及輸出是否真的符合這次輸入與設定。
本篇把 input 和 output 分開,只處理最直接的覆寫風險;它不是備份、版本歷史、檔案鎖或正式資料安全方案。
README 怎樣才真的能讓別人重跑?
README 的目的不是看起來完整,而是消除只有作者知道的隱藏前提。
至少要交代:
| 問題 | 本篇答案 |
|---|---|
| 用什麼環境? | 可用的 Python 3 |
| 要裝什麼? | 不需第三方套件 |
| 哪些檔案不能缺? | main.py、helpers.py、data/notes.json |
| 怎麼啟動? | python main.py |
| 輸入是什麼? | UTF-8 JSON 筆記陣列 |
| 預期結果? | 4 筆讀入、2 筆輸出 |
| 會改什麼? | 建立/覆寫 output/selected.json |
| 有什麼限制? | 無歷史備份、無檔案鎖、不適合重要資料 |
最直接的驗收是:關掉原終端機,開一個新的,只照 README 從頭執行。
工作目錄也只需要驗證一次。本篇用 Path(__file__).resolve().parent 當資料路徑基準,所以即使從父資料夾執行 script,輸入與輸出仍應落在同一個專案。若問題是 import 找不到 module,就回到上一節的 helpers.__file__ 診斷,不再重複另一套教學。
怎麼驗收自己真的看懂?
最後做三個小變化,每次都先預測,再看證據:
- 把
min_minutes從 20 改成 25,先預測哪一筆留下,再核對輸出 JSON。 - 在
notes.json增加一筆合成資料,先判斷它會不會被選中,再確認原始四筆沒有意外消失。 - 關掉原程序,開新終端機,只照 README 重跑,再重新讀取結果檔。
如果你能沿著:
入口
→ module
→ 檔案讀取
→ Python 資料
→ instance
→ method
→ 檔案寫入
→ 新程序重新讀取
說明每一步由誰負責;遇到錯誤時也能先指出是檔案、資料格式、import 還是呼叫參數問題,再做最小修正,就已經達到這篇的停止線。
停止線與技術來源
本篇來源範圍固定為 AI Engineering Foundations v1.0 的 P05 + S01–S03:
- P05:檔案、編碼、持久化
- S01:module、import、namespace、搜尋路徑與入口
- S02:class、instance、
self、__init__與物件狀態 - S03:README、資料、依賴與重現步驟
不進 packaging、deployment、Docker、database、framework architecture、HTTP / external API、Git version control 或 complex inheritance。下一篇才比較 Library、SDK、Framework 與 API 的角色。
技術細節可對照 Python 官方文件:
本篇筆記資料是合成教材,不是外部專案實績。