Python 程式怎麼處理資料?從變數、容器到條件與函數
學 Python 時,最容易出現一種錯覺:
每一行好像都看得懂,但整段程式放在一起,就不知道資料到底跑去哪裡了。
例如你看到:
minutes = "30"
你知道這是在「存一個值」。
看到:
if minutes >= 30:
    ...
你也知道這是在「做條件判斷」。
看到:
def filter_notes(...):
    ...
你知道這是在「定義函數」。
但真正重要的能力不是認出這些語法名稱,而是回答:
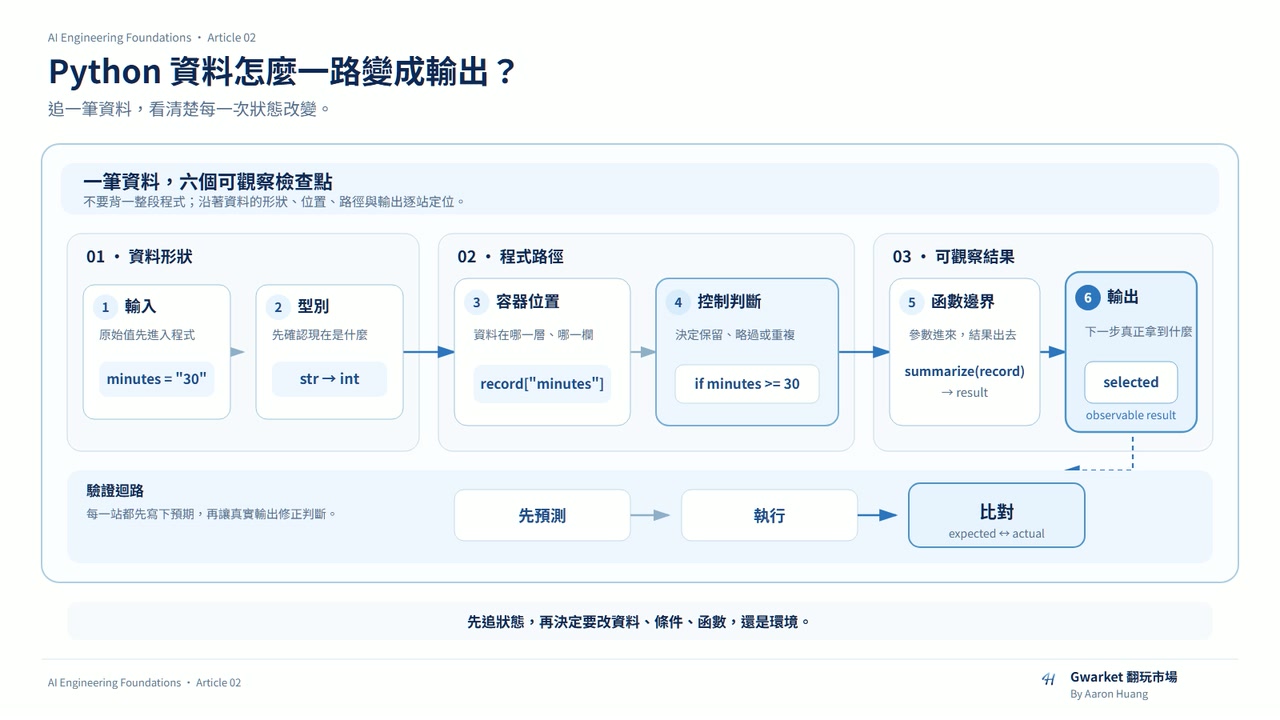
一筆輸入進來之後,經過了哪些變化,最後為什麼會得到這個輸出?
Article 02 就只處理這件事。
這篇不會把 Python 變成一份完整語法百科,而是先建立一條可以實際追蹤的資料流:
輸入
↓
值與型別
↓
容器
↓
條件 / 迴圈
↓
函數
↓
回傳值
↓
輸出
只要這條線能追得動,之後看到更大的程式時,你才不會只剩下「這裡有很多 Python 語法」這種模糊印象。
先從最小單位開始:變數裡到底放了什麼?
先看兩個值:
a = "3"
b = 3
它們看起來都像「3」。
但程式不只看畫面長得像不像。
它還會處理:
- 這個值是什麼
- 這個值屬於哪種型別
- 後面的操作允不允許這種型別參與
可以先直接觀察:
a = "3"
b = 3

print(a)
print(type(a))

print(b)
print(type(b))
這裡先建立四個概念:
名稱
→ 值
→ 型別
→ 後續操作
a 和 b 是名稱。
"3" 和 3 是它們目前指向的值。
而型別會影響後面的資料能怎麼被使用。
因此「變數」不是一個神祕盒子。
對這篇文章來說,你可以先把它理解成:
程式用一個名稱,讓後面的步驟可以再次取得某個值。
型別問題不是靠猜,要沿著資料流找
假設使用者輸入了一段文字:
minutes_text = "30"
但接下來你想把它當成數字使用。
這時資料流中間就多了一個轉換步驟:
"30"
↓
文字
↓
轉換
↓
30
↓
數字
例如:
minutes_text = "30"
minutes = int(minutes_text)

print(type(minutes_text))
print(type(minutes))
這裡真正要學的不是背 int()。
而是學會問:
現在這個值,在這一步應該是什麼型別?
如果輸入改成:
minutes_text = "thirty"
minutes = int(minutes_text)
轉換就會失敗。
這時至少要區分兩種問題:
資料本身不合法
vs.
程式漏掉必要轉換
例如:
minutes_text = "30"
本身可以表示一個數字,只是目前還是文字。
但:
minutes_text = "thirty"
如果你的規則要求這裡必須是數字,那問題就在輸入本身。
這種區分很重要。
否則新手很容易看到錯誤就直接改程式,卻沒有先確認:
到底是資料錯,還是處理資料的步驟錯。
第二層:多筆資料為什麼需要容器?
單一值很好追。
但實際程式很快就會遇到多筆資料。
例如三筆學習筆記:
notes = [
    {"title": "Python", "minutes": 30, "done": True},
    {"title": "Git", "minutes": 20, "done": False},
    {"title": "API", "minutes": 45, "done": False},
]
這時不要急著把它看成一大坨括號。
先拆層次:
外層
notes
↓
list
↓
每一筆
dict
↓
欄位
title / minutes / done
↓
欄位值
"Python" / 30 / True
只要先回答三個問題,巢狀資料就比較不容易亂:
- 外層是什麼?
- 每一筆是什麼?
- 我要的欄位在哪裡?
例如取得第一筆的標題:
print(notes[0]["title"])
你可以把這行拆成兩步理解:
notes[0]
→ 先取得第一筆 dict

["title"]
→ 再從這筆 dict 取得 title
不是一次看懂整行,而是逐層取值。
list、dict、set、tuple 不只是四個單字
母文件要求的重點不是背四種容器名稱,而是比較四件事:
- 順序
- 鍵值對應
- 重複項目
- 可變性
先用一個工作模型理解:
| 容器 | 先問自己的問題 |
|---|---|
| list | 我是不是有一組依序處理的資料? |
| dict | 我是不是要用欄位名稱找到值? |
| set | 我是不是更在意項目是否重複,而不是位置? |
| tuple | 我是不是要表達一組不打算直接修改的有序值? |
在這篇裡,不需要把所有方法都學完。
先做到:
看到資料需求時,可以說明自己為什麼選這個容器。
例如三筆學習筆記本身適合依序處理,所以外層可以用 list。
每一筆又有 title、minutes、done 這些欄位,所以單筆可以用 dict。
如果你只是想知道出現過哪些主題,不想保留重複項目,可以另外建立一個 set。
先預測,再修改資料
現在對第一筆資料做修改:
notes[0]["minutes"] = 35
執行前先回答:
哪一個值會改?
不是「notes 會改」。
而是更精確地說:
notes
└── 第 1 筆
    └── minutes
        30 → 35
這就是資料流訓練。
每次修改前,先指出:
- 改的是哪一層
- 舊值是什麼
- 新值是什麼
- 其他欄位會不會被影響
這個習慣比一次學很多容器方法更有價值。
容器常見錯誤:你取錯了哪一層?
假設你寫:
print(notes[10])
問題不是「list 壞掉」。
而是你要求了一個目前不存在的位置。
再例如:
print(notes[0]["score"])
如果第一筆資料沒有 score 這個鍵,問題也不是「dict 壞掉」。
而是:
你假設資料裡有一個實際不存在的欄位。
所以碰到容器錯誤時,不要先全面重寫。
先問:
我現在拿的是哪個容器?
↓
我要的是位置還是鍵?
↓
那個位置 / 鍵真的存在嗎?
第三層:條件讓資料走不同的路
現在假設需求是:
找出還沒完成,而且學習時間至少 30 分鐘的筆記。
先不要直接寫完整程式。
把規則拆開:
每一筆 note
↓
done 是否為 False?
↓
minutes 是否至少 30?
↓
兩個條件都符合
↓
保留
接著才寫:
selected = []

for note in notes:
    if not note["done"] and note["minutes"] >= 30:
        selected.append(note)
這段程式的重點不是 for 和 if 長什麼樣。
真正要追的是每一輪:
目前是哪一筆?
↓
條件結果是 True 還是 False?
↓
selected 有沒有改變?
以剛才的資料來看:
| 目前項目 | done | minutes | 是否保留 |
|---|---|---|---|
| Python | True | 35 | 否 |
| Git | False | 20 | 否 |
| API | False | 45 | 是 |
如果你在執行前就能預測這張表,代表你開始真的在讀控制流程,而不是只認語法。
for、while、break、continue 到底差在哪?
這篇不需要把控制流程全部展開成語法大全。
先抓住它們對「程式下一步走哪裡」的影響:
if
→ 這一次要不要走某條分支?

for
→ 對一組項目逐筆處理

while
→ 只要條件仍成立,就繼續重複

continue
→ 這一輪剩下的步驟先跳過,進下一輪

break
→ 直接結束目前迴圈
例如你想略過沒有標題的資料:
for note in notes:
    if not note["title"]:
        continue

    print(note["title"])
而如果需求是:
找到第一筆符合條件的資料就停止
才可能使用:
for note in notes:
    if note["minutes"] >= 30 and not note["done"]:
        print(note)
        break
重點不是「哪個比較厲害」。
而是:
你要能解釋它讓控制流程跳到哪裡。
迴圈最危險的不是語法錯,而是狀態沒有照預期更新
假設你想用 while 做一個簡單計數:
count = 0

while count < 3:
    print(count)
    count += 1
你應該可以手動追蹤:
count = 0
↓
0 < 3 → 執行
↓
count = 1

1 < 3 → 執行
↓
count = 2

2 < 3 → 執行
↓
count = 3

3 < 3 → False
↓
停止
如果你漏掉:
count += 1
那真正的問題不是「while 很危險」。
而是:
控制迴圈結束的狀態沒有被更新。
因此看到迴圈問題時,至少要追三件事:
- 起始狀態是什麼?
- 每一輪改了什麼?
- 哪個條件會讓它停止?
邊界值要先想,不要等結果怪怪的再猜
回到剛才的條件:
note["minutes"] >= 30
假設資料剛好是:
{"title": "SQL", "minutes": 30, "done": False}
它要不要被保留?
這取決於你的規則到底是:
至少 30 分鐘
→ >= 30
還是:
超過 30 分鐘
→ > 30
所以條件判斷真正要驗證的是需求邊界,不只是程式有沒有跑。
第四層:函數把一段資料流包成可重複呼叫的步驟
目前我們的篩選程式是:
selected = []

for note in notes:
    if not note["done"] and note["minutes"] >= 30:
        selected.append(note)
如果這個步驟之後還會重複用,就可以把它整理成函數:
def filter_notes(notes, min_minutes):
    selected = []

    for note in notes:
        if not note["done"] and note["minutes"] >= min_minutes:
            selected.append(note)

    return selected
這時資料流變成:
呼叫者
↓
傳入 notes + min_minutes
↓
函數內部處理
↓
selected
↓
return
↓
呼叫者取得結果
你可以先預測:
result = filter_notes(notes, 30)
result 應該拿到什麼?
再執行確認。
這就是母文件在 P04 要建立的能力:
把函數看成有輸入、有處理、有輸出的契約。
print() 和 return 最大的差別,不是畫面有沒有東西
看這兩個函數:
def show_count(notes):
    print(len(notes))
以及:
def get_count(notes):
    return len(notes)
第一個函數的重點是把內容顯示出來。
第二個函數的重點是把結果交回呼叫者,讓後面的程式可以繼續使用。
例如:
count = get_count(notes)
print(count + 1)
這條資料流是:
notes
↓
get_count()
↓
回傳 count
↓
count + 1
↓
輸出
因此當你遇到:
「函數裡明明有算出值,為什麼外面拿不到?」
不要只看函數裡有沒有 print()。
要看:
這個值有沒有沿著 return 回到呼叫者。
Controlled failure:故意漏掉 return
先看這個版本:
def filter_notes(notes, min_minutes):
    selected = []

    for note in notes:
        if not note["done"] and note["minutes"] >= min_minutes:
            selected.append(note)

    print(selected)
畫面上可能真的會印出結果。
但呼叫者如果寫:
result = filter_notes(notes, 30)
就不能因為「剛才畫面有印東西」而直接認定 result 已經拿到那份篩選結果。
這正是 print() 與 return 容易被混在一起的地方。
最小修正不是重寫整個函數。
而是先確認輸出契約:
這個函數是不是本來就應該把 selected 交回呼叫者?
如果是,就應該讓回傳路徑成立。
函數還要注意:你是在回傳新結果,還是在改外面的資料?
看兩種做法。
第一種:
def add_note(notes, note):
    notes.append(note)
它直接修改傳進來的容器。
第二種可以設計成:
def add_note_copy(notes, note):
    updated = list(notes)
    updated.append(note)
    return updated
這篇不需要深入物件底層實作。
現在只要先建立一個檢查問題:
呼叫函數之後,原本那份資料會不會被改掉?
這會直接影響你後面怎麼追資料流。
如果不知道一個函數會不會修改外部資料,你就很難判斷:
「到底是哪一步把資料變掉了?」
把兩個函數接起來,資料流才真正完整
現在把篩選與計數分開:
def filter_notes(notes, min_minutes):
    selected = []

    for note in notes:
        if not note["done"] and note["minutes"] >= min_minutes:
            selected.append(note)

    return selected


def count_notes(notes):
    return len(notes)
接著:
selected = filter_notes(notes, 30)
count = count_notes(selected)

print(count)
不要只看成「呼叫兩個函數」。
把它讀成:
原始 notes
↓
filter_notes()
↓
selected
↓
count_notes()
↓
count
↓
print()
這就是 Article 02 最重要的能力。
當程式變長時,你仍然可以問:
- 這一步收到什麼?
- 它改了什麼?
- 它傳出什麼?
- 下一步拿到的是哪個結果?
一個完整的小練習:先預測,再執行
把目前內容收斂成一個小例子:
notes = [
    {"title": "Python", "minutes": 35, "done": True},
    {"title": "Git", "minutes": 20, "done": False},
    {"title": "API", "minutes": 45, "done": False},
    {"title": "SQL", "minutes": 30, "done": False},
]


def filter_notes(notes, min_minutes):
    selected = []

    for note in notes:
        if not note["title"]:
            continue

        if note["done"]:
            continue

        if note["minutes"] >= min_minutes:
            selected.append(note)

    return selected


def get_titles(notes):
    titles = []

    for note in notes:
        titles.append(note["title"])

    return titles


selected = filter_notes(notes, 30)
titles = get_titles(selected)

print(titles)
執行前先不要跑。
先回答:
selected會有幾筆?- 哪些資料會因為
done被略過? minutes == 30會不會通過?get_titles()收到的是原始notes,還是篩選後的結果?- 最後
titles應該是什麼?
接著再執行。
如果結果和預測不同,不要立刻改程式。
先沿著資料流逐步比對:
原始資料
↓
容器層次是否正確?
↓
條件結果是否和預期一致?
↓
每一輪狀態是否正確更新?
↓
函數輸入是否正確?
↓
return 是否把正確結果交回來?
↓
最終輸出
這篇真正要驗收的,不是你背了多少 Python
Article 02 到這裡,驗收標準很簡單。
給你一段小型程式時,你應該開始能做到:
- 指出資料一開始是什麼值與型別
- 看懂外層容器、單筆資料與欄位值
- 預測 if 會走哪個分支
- 手動追蹤 for / while 每一輪的狀態變化
- 說明 break / continue 改變了哪一步
- 說明函數收到什麼參數、回傳什麼結果
- 區分顯示結果與把結果交回呼叫者
- 找到型別、鍵 / 索引、終止條件或 return 問題的最小修正位置
做到這些,就已經達到這篇的停止線。
下一篇才進入「一個程式怎麼變成小專案」
這篇刻意停在單一小型資料流。
先不進:
- 檔案與持久化
- 多個
.py檔 - module / import
- class
- README
- packaging
- 部署
Article 03 才會接著回答:
當資料需要留下來、程式需要拆成多個檔案,而且同一套流程要能重新執行時,一段 Python 要怎麼變成一個可理解、可重跑的小專案?
所以 Article 02 的結論不是「我學完 Python 了」。
而是:
我已經可以沿著值、容器、控制流程與函數,追出一筆資料怎麼從輸入走到輸出。