LLM 不是知識庫:從下一個 Token 理解 AI 為什麼會一本正經地答錯
如果你正在學 AI Agent,很容易先把注意力放在工具調用、MCP、RAG、多 Agent 或記憶系統上。但在這些架構之前,有一個更基本的問題:
LLM 到底在做什麼?
這個問題如果理解錯,後面的系統設計很容易一起錯。
先給答案:
本文討論的自回歸 LLM,會根據目前可見的輸入,估計下一個 token 的條件機率,再一步一步生成後續內容。它很擅長產生合理的語言序列,但「產生合理內容」與「驗證事實正確」是兩件不同的事。 1
這不代表 LLM 只是沒有能力的文字接龍。大型語言模型可以從大量資料中學到複雜的語言、概念、程式與推理模式。真正需要建立的心智模型是:LLM 可以很強,但它仍然只是 AI 系統中的一個機率生成元件,不是完整的事實系統。 2
先說清楚標題的範圍:「不是知識庫」不是說模型沒有知識。模型參數確實能承載訓練中學到的事實關聯;這裡反對的是把生成回答當成具有來源、版本與逐項查證保證的資料庫查詢。本文以自回歸文字生成為主,不把所有語言模型架構都說成同一種機制。3 4
目錄
- 1. 下一個 Token 應該是什麼?
- 2. 為什麼能產生複雜能力?
- 3. 為什麼情境會改變答案?
- 4. 流暢為什麼不等於正確?
- 5. 什麼時候需要系統補足?
- 6. Model、產品、應用與 Agent
- 7. 工程師真正設計什麼?
- 8. 五個常見誤解
- 9. 結論
- 來源與驗證範圍
1. LLM 的基本問題:下一個 Token 應該是什麼?
Token 可以先理解成模型處理文字時使用的單位。它不一定等於一個中文字,也不一定等於一個英文單字;實際切分方式取決於 tokenizer。
對這篇文章來說,先不深入 token 怎麼切,只看語言模型最核心的生成問題:
在已知前面內容的情況下,下一個 token 最可能是什麼?
簡化後,可以表示成:
P(x_n | x_1, x_2, ... x_(n-1))
意思是:模型看到前面的 token 後,估計下一個 token 的機率分布。
以下是概念示例,不是某個模型的實測輸出。假設輸入是:
The capital of France is
模型的生成操作不是從某個「答案庫」直接查出完整句子。理解生成方式的概念流程是:
目前輸入
  ↓
計算下一個 token 的候選分布
  ↓
依生成策略選出下一個 token
  ↓
把新 token 加回序列
  ↓
再次預測
  ↓
持續重複
一段完整回答因此是透過 autoregressive generation(自回歸生成) 一步一步產生。1
這是理解 LLM 的第一個關鍵:
回答是在目前條件下逐步生成,而不是一次資料庫查詢。這也不代表模型絕不會重現訓練中出現過的文字。
2. 既然只是預測下一個 Token,為什麼可以寫程式、翻譯甚至推理?
這裡常出現第一個過度簡化:
「LLM 不就是猜下一個字嗎?那它根本沒有真的能力。」
問題在於,「預測下一個 token」聽起來很簡單,但在大量、複雜而多樣的語言資料中學習這件事,模型可以學到大量可重複利用的結構。
例如:
- 文法與語氣模式
- 詞與概念之間的關聯
- 問題與回答的結構
- 常見程式碼模式
- 摘要與翻譯的對應關係
- 任務示範中可重用的規律
因此,訓練目標是 next-token prediction,不代表模型只學會表面的字詞接續。
大型語言模型可以形成複雜的 representations(表徵),並利用學到的規律完成不同任務。GPT-3 研究展示了翻譯、問答及部分需要當場推理的任務表現,也記錄了失敗與限制;不能把它解讀成所有任務都可靠。2
還要區分預訓練與後訓練。下一個 token 預測不是所有訓練階段的完整描述。例如 InstructGPT 先使用示範資料做監督式微調,再透過人類回饋強化學習調整行為;研究顯示這能改善部分真實性表現,但模型仍會犯錯。5
但接著又容易走到另一個極端:
「既然模型會推理,那它講的內容應該是真的。」
這也不成立。
能力與可靠性是不同維度。
模型可以生成很像合理推理的內容,卻建立在錯誤前提上;也可以產生結構完整、語氣自然、甚至很專業的說明,但其中的人名、日期、數字或來源並沒有被外部系統驗證。
比較精確的說法是:
Next-token prediction 是理解自回歸模型的起點,不是完整訓練配方;模型學到的能力,也不會自動附帶事實正確、資訊即時、輸出可重現或安全的保證。
3. 同一個模型為什麼換個情境,答案就可能不同?
如果只把 AI 系統理解成「模型本身」,會漏掉真正影響輸出的另一半。
可以先用一個簡化的工程模型理解:
Output = f(Model, Context, Sampling)
這不是正式數學定義,而是一個方便拆解系統的概念模型。
其中的 Context 不只是使用者最後輸入的那句話。實際 AI 應用可能還會加入:
- system / developer instructions
- 先前對話
- 使用者提供的文件
- RAG 取回的資料
- 工具執行結果
- 範例
- 輸出格式要求
Sampling 則影響系統如何從候選 token 分布產生輸出。
這代表:
LLM 的答案不是只由「模型有多強」決定。
如果輸出不好,工程排查時可以檢查:
- 任務描述不清楚
- 正確資料根本沒有進入 context
- context 中存在互相衝突的資訊
- 無關資訊太多
- 輸出空間過度自由
- 後續沒有驗證
這是排查方向,不是已完成的根因診斷。長上下文研究也提醒,輸入容量與實際使用資訊的能力不同;特定研究中的結果不能一概套用到所有新模型。6
所以 AI 應用出錯時,只問「是不是要換更強的模型?」往往太早。
模型只是整個系統的一個 component。
4. 為什麼 LLM 可以非常流暢,卻仍然答錯?
閱讀時,不能把「寫得像真的」直接當成「是真的」。
模型可能產生:
- 看起來合理的人名
- 符合格式的日期
- 很像真的論文名稱
- 語法完整的因果說明
- 相當有自信的語氣
這些是需要核對的主張類型,不是本篇實測得到的錯誤清單。整段文字可以非常自然,但不代表每一個主張背後都有可靠來源。TruthfulQA 曾針對受測模型是否重現常見錯誤觀念做評估;它支持「語言生成與真實性應分開評估」,不代表今天所有模型的錯誤率。7
因此要把三件事拆開:
語言合理性 ≠ 事實正確性
高自信語氣 ≠ 高可信度
回答很完整 ≠ 推理已被驗證
不需要先把錯誤歸因於模型「故意說謊」。更有用的工程觀點是:
生成系統可以產生看似合理的後續內容,但生成本身沒有保證每一個事實主張都經過外部查核。
理解這件事之後,AI 應用的架構就會開始改變。
5. 什麼時候不能只做 User → LLM → Answer?
對低風險任務,例如改寫文案、整理想法或腦力激盪,直接讓模型生成答案可能已經足夠。
但當任務依賴可驗證的外部事實時,單純:
User → LLM → Answer
就可能不夠。
例如系統需要處理:
- 最新政策或規則
- 公司內部的正式資料
- 某筆訂單或即時狀態
- 必須引用來源的研究問題
- 會直接觸發後續動作的判斷
這時更合理的設計可能是:
Authoritative Source
        ↓
Retrieval / API / Tool
        ↓
       LLM
        ↓
Citation / Validation
        ↓
      Answer
這是依風險選配的設計示意,不是通用標準流程,也不是零錯誤保證。RAG 將外部檢索資訊與模型生成結合,但檢索可能取錯資料,模型也可能誤解內容;附上引用不等於引用真的支持主張,仍需核對。 4
這不代表所有 AI 應用都必須加 RAG、搜尋或 Agent。
真正該問的是:
這個任務如果答錯,代價是多少?答案需不需要外部證據?系統有沒有辦法驗證?
風險越高,就越不能把「模型生成得像答案」直接當成「系統已正確完成任務」。
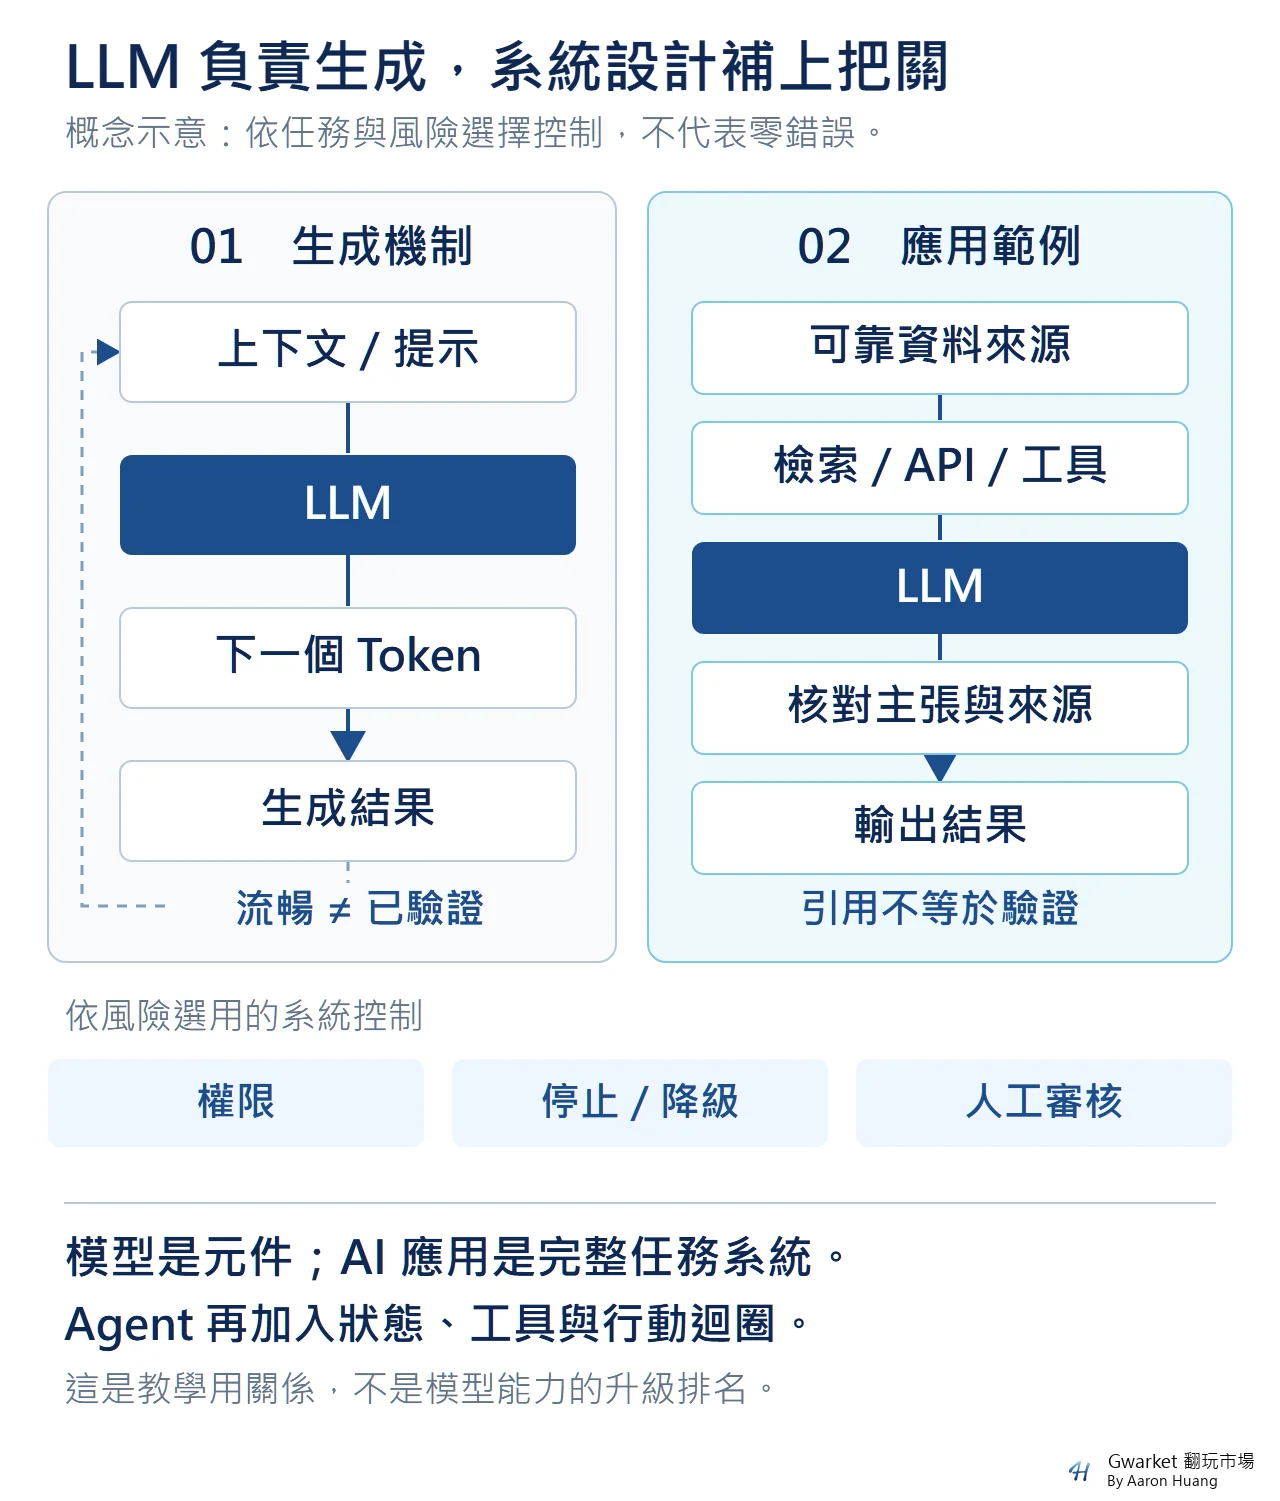
圖:原創教學示意,不是模型實測。右側只是一種應用組合;引用、驗證及人工介入仍有各自限制。
6. Model、Chat Product、AI Application、Agent 是不同層次
很多 AI 討論會把這四個詞混在一起,結果很難判斷能力到底來自哪裡、錯誤又發生在哪一層。
可以先用這個簡化框架理解:
| 層次 | 核心角色 | 可能包含什麼 |
|---|---|---|
| Model | 產生輸出 | LLM 本身 |
| Chat Product | 提供對話體驗 | 模型、UI、搜尋、檔案、記憶、安全政策、工具 |
| AI Application | 完成特定任務 | 模型、資料、程式邏輯、介面、權限、驗證與監控 |
| Agent | 依狀態與回饋選擇下一步行動 | AI application 再加入 state、decision loop、tools、actions 與治理 |
也可以把它當成一個教學用的概念關係:
LLM
= probabilistic generation component

AI application
= LLM + data + code + interface + controls

Agent
= AI application + state + tools + action loop + governance
這不是業界唯一正式定義,也不是互斥的四個分類:對話產品本身也可以是 AI 應用,並包含 Agent。固定工作流同樣能呼叫工具;在這篇使用的架構區分中,Agent 的重點是模型依狀態與環境回饋動態決定下一步,而不是單純多接一個工具。8
最重要的是:
Agent 不是「比 LLM 更高級的一顆模型」。Agent 通常是一個系統層級的設計。
因此,當 Agent 答錯、工具呼叫失敗,或執行到不該執行的動作時,問題未必只是模型能力。
也可能是:
- context 組裝錯誤
- 工具回傳資料錯誤
- 權限設計錯誤
- 決策流程缺少停止條件
- 缺少 validation
- 應用把模型輸出直接當成可信指令
這也是為什麼學 Agent 不能只學 Prompt。
7. AI Application Engineer 真正要設計的是什麼?
如果 LLM 是一個機率生成元件,AI 應用工程的工作就不只是「讓模型回答」。
真正要設計的是邊界。以下是依前文整理的工程判斷問題,不是唯一標準答案。
模型應該看到什麼?
哪些資料應該進 context?哪些資料不該進?
哪些事實必須從外部取得?
需要 RAG、API、資料庫還是其他工具?
哪些輸出可以直接使用?
創意文案與付款指令的容錯程度完全不同。
哪些結果必須被驗證?
要檢查格式、來源、數值、權限,還是需要人類批准?
模型失敗時系統怎麼辦?
重試、拒答、降級、轉人工,還是停止?
這些問題,才是從「會用模型」走向「會設計 AI 系統」的分界。
8. 五個常見誤解
| 常見說法 | 更精確的理解 |
|---|---|
| LLM 就是在查資料庫 | LLM 可以承載知識,但生成操作不等於具來源與版本保證的資料庫查詢 |
| LLM 只是文字接龍,所以沒有能力 | Next-token prediction 可以學到複雜 representations,但不代表所有輸出可靠 |
| 模型說得很完整,所以應該是真的 | 語言品質與事實正確是兩個不同維度 |
| 換最強模型就能解決所有問題 | Context、資料、工具、驗證與流程設計都會影響結果 |
| Agent 是比 LLM 更高級的模型 | Agent 是結合模型、狀態、工具與動態行動迴圈的系統設計 |
9. 結論:不要把一個機率生成元件誤當成完整系統
理解 LLM 的目的,不是降低它的價值。
恰恰相反,只有知道它真正擅長什麼,我們才知道怎麼把它用好。
LLM 擅長處理語言、語義與模糊模式,也能展現複雜的生成與推理能力。但模型本身不天然保證:
- 每個事實都正確
- 資訊一定是最新
- 每次輸出完全一致
- 每個行動都符合系統權限與安全需求
所以 AI 應用工程的起點,不是問:
「我要怎麼讓 LLM 什麼都會?」
而是問:
「這個任務裡,哪些事情可以交給機率生成,哪些事情必須由資料、程式、工具、驗證與人類決策來補足?」
一旦這個問題清楚,RAG、tools、validation、evaluation,甚至 Agent 架構才有真正的用途。
下一篇會繼續往下一層拆:
如果 LLM 的回答取決於它當下看到的條件,那這些資訊怎麼進入模型?Context Window 是什麼?為什麼塞更多資料不一定更好?
來源與驗證範圍
本篇由 Hello-Agents 第三章學習母資料延伸,並於 2026-09-19 核對以下原始研究摘要及官方文件的相關內容。本文沒有重新訓練或測試模型,也沒有主張任何現行模型的錯誤率;流程、公式簡寫與圖解均是教學模型,系統選配屬工程判斷。文獻中的歷史實驗不代表所有新模型。
- Hugging Face — Causal language modeling:自回歸生成範圍。
- Brown et al. (2020), Language Models are Few-Shot Learners:能力與限制。
- Petroni et al. (2019), Language Models as Knowledge Bases?:模型可承載事實關聯。
- Lewis et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks:參數知識與外部檢索的結合;參考 v4(2021)。
- Ouyang et al. (2022), Training language models to follow instructions with human feedback:後訓練與限制。
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts:輸入容量與資訊使用的區別。
- Lin et al., TruthfulQA: Measuring How Models Mimic Human Falsehoods:真實性需要獨立評估。
- Anthropic, Building effective agents:工作流與 Agent 的架構區分。
- Hello-Agents:第三章 大語言模型基礎:原始學習脈絡。