LLM、RAG、Workflow、Agent 怎麼選?最低必要複雜度
上一篇,我們把 Agent 定義成一個閉環系統:
Goal
↓
Observe
↓
Decide
↓
Act
↓
Observe Result
↓
Continue or Stop
理解 Agent 之後,很容易出現下一個誤區:
既然 Agent 可以自己決定下一步,那是不是所有 AI Application 最後都應該做成 Agent?
不一定。
甚至很多情況下,這會讓原本簡單的問題變得更難。
因為架構真正要回答的問題從來不是:
哪個技術比較先進?
而是:
完成這個任務,最少需要多少系統複雜度?
這也是這篇文章最重要的原則:
Minimum Necessary Complexity
只加入完成任務真正需要的能力。
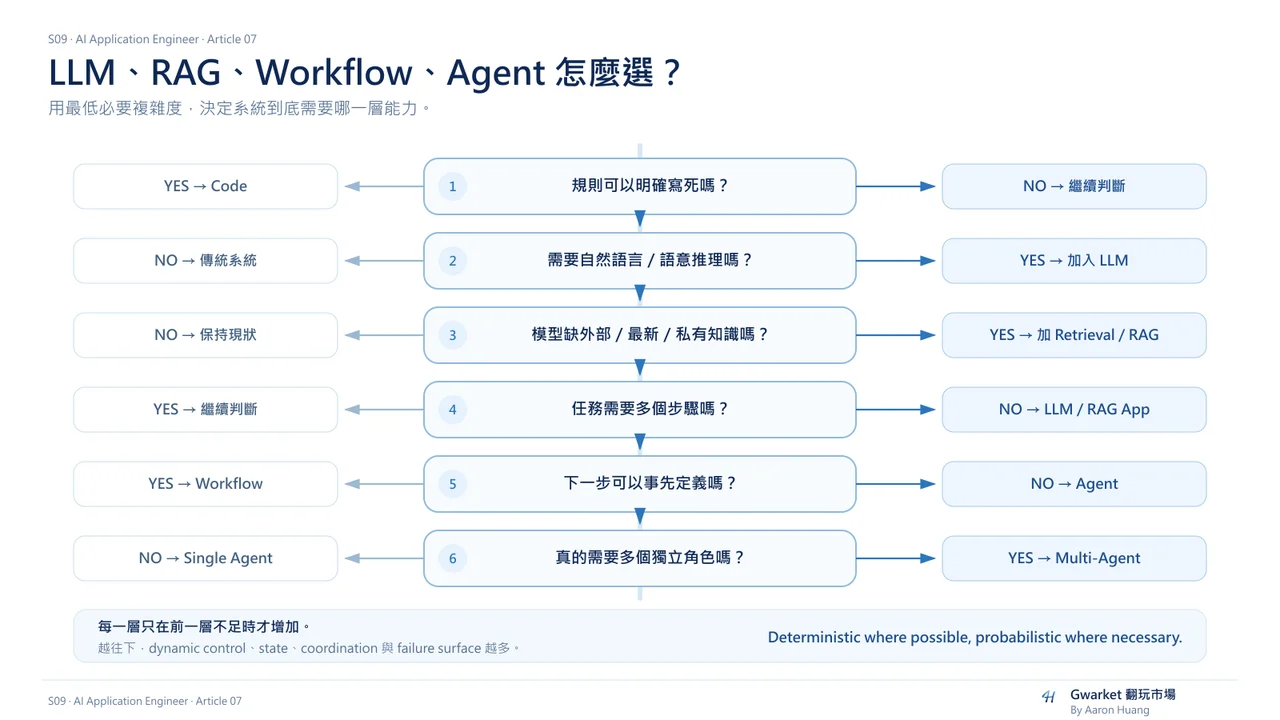
一、先從第一性原理看:架構是拿來解決限制,不是拿來堆功能
假設現在有六種選擇:
Deterministic Code
LLM
RAG
Workflow
Agent
Multi-Agent
很容易把它們理解成:
簡單
↓
高級
↓
更高級
但這其實不是一條能力排行榜。
它們解決的是不同問題。
例如:
| 架構 | 主要解決什麼問題? |
|---|---|
| Deterministic Code | 規則已知,可以明確計算 |
| LLM | 語言與語意具有模糊性 |
| RAG | 模型缺少完成任務需要的外部知識 |
| Workflow | 任務有多個步驟,但順序大致已知 |
| Agent | 下一步必須根據執行結果動態決定 |
| Multi-Agent | 任務真的需要多個獨立角色/Context/子目標協作 |
因此真正的架構選型應該是:
先確認問題
↓
找出最小能力缺口
↓
只增加能補上這個缺口的 component
而不是:
我要做 AI
↓
所以我要做 Agent
二、第一層永遠應該先問:可以直接寫 Code 嗎?
AI 很容易讓人忘記一件事情:
傳統程式在很多問題上其實比 LLM 更好。
假設你要算:
訂單金額 = 1,000
退款比例 = 20%
答案就是:
refund = 1000 × 0.2
這時候:
refund = order_amount * refund_rate
比叫 LLM:
請幫我推理應該退款多少。
更合理。
因為 deterministic code:
- 可預測
- 可測試
- 速度快
- 成本低
- 容易 debug
所以第一個問題應該永遠是:
這件事情能不能被明確寫成規則?
如果答案是可以:
先用 Code。
三、什麼時候才需要 LLM?
現在問題變成:
這封客訴 Email 的主要意圖是什麼?
可能有:
退款
抱怨
技術問題
帳號問題
詢問
但使用者不會按照固定 schema 說話。
他可能寫:
我昨天買的東西完全不能用,而且客服兩天都沒有回覆,我已經不想再浪費時間了。
這時 deterministic rule 很難涵蓋所有語言表達。
LLM 的價值開始出現。
因為我們需要的是:
semantic interpretation
而不是純計算。
因此可以把 LLM 理解成:
當問題中的主要不確定性來自語言、語意或開放式生成時,引入 probabilistic reasoning。
例如:
摘要
分類
改寫
資訊擷取
語意比較
自然語言生成
這些都是 LLM 很自然的使用場景。
四、但 LLM 不知道,就不要期待它「想得更久」會知道
假設使用者問:
公司現在的差旅補助上限是多少?
LLM 本身可能:
- 沒看過公司規章
- 看過舊資料
- 根本沒有這家公司資訊
這時候問題不是:
Reasoning 不夠強
而是:
Knowledge 不在 Context
這就是 RAG / Retrieval 開始出現的地方。
五、RAG 解決的是 Knowledge Gap
RAG 的核心概念其實很簡單:
Question
↓
Retrieve relevant information
↓
Put evidence into Context
↓
LLM
↓
Answer
例如:
使用者:
海外出差住宿上限?

↓

搜尋公司內部 travel policy

↓

找到:
Tokyo:JPY 20,000 / night

↓

LLM 根據文件回答
RAG 真正增加的是:
External Knowledge Access
而不是:
讓模型變聰明。
這個區別非常重要。
如果模型的問題是:
沒有資料
那 Retrieval 很合理。
但如果問題是:
明明資料都有,模型還是推理錯
再加 Vector Database 通常不會解決根本問題。
六、RAG 也不是一定等於 Vector Database
這裡順便拆掉另一個常見誤會。
RAG 不必然代表:
Embedding
+
Vector DB
Retrieval 可以來自:
Search Engine
Database
SQL
Document Index
Keyword Search
Vector Search
Hybrid Search
API
真正重要的是:
在需要回答之前,把正確的 evidence 放進模型當下的 Context。
所以選 RAG 時真正要問的不是:
要用哪一套 Vector DB?
而是:
模型現在缺的是不是外部知識?
七、有 LLM + RAG 之後,還需要 Workflow 嗎?
假設你現在每天要做:
抓新聞
↓
過濾
↓
分類
↓
摘要
↓
生成報告
↓
寄 Email
這個任務不是一次 LLM call。
但每一步其實已經知道。
所以我們可以直接把流程寫成:
Step 1
↓
Step 2
↓
Step 3
↓
Step 4
↓
Step 5
這就是:
Workflow。
八、Workflow 解決的是「多步驟」,不是「自主性」
Workflow 的核心特性是:
Control Flow 大部分由工程師預先定義。
例如:
取得資料
↓
if 資料為空 → Stop
↓
清理資料
↓
LLM summarize
↓
validate
↓
save
裡面完全可以有:
- LLM
- RAG
- API
- Tool
- Database
但整體流程仍然可以是 deterministic。
所以:
LLM + Tools + Multiple Steps
仍然不一定是 Agent。
它可能只是一個很好的 Workflow。
九、Workflow 的優勢其實非常大
如果任務流程已知,Workflow 通常有幾個優勢:
比較容易 debug
比較容易測試
比較容易預估 cost
比較容易控制 latency
比較容易限制 permission
比較容易知道哪一步失敗
例如:
Retrieve
↓
Summarize
↓
Validate
↓
Publish Draft
如果出錯,你可以直接知道:
Validation failed
而不是問:
Agent 剛剛到底為什麼決定做這件事情?
所以:
能用 Workflow 解決,就沒有必要先假設需要 Agent。
十、什麼時候 Workflow 開始不夠?
回到上一篇的例子:
幫我修好這個 bug。
我們很難預先寫:
Step 1:讀 A.py
Step 2:修改第 37 行
Step 3:跑 test_x
Step 4:修改 B.py
因為在任務開始前,我們根本不知道:
- bug 在哪
- 哪個 test 會 fail
- 修改之後會發生什麼
- 是否需要讀其他檔案
- 是否需要重新規劃
也就是:
下一步取決於前一步的 Observation。
這時才真正需要上一篇談的 Agent loop:
Observe
↓
Decide
↓
Act
↓
Observe Result
↓
Decide Again
十一、Agent 解決的是 Process Uncertainty
可以把 Workflow 和 Agent 最核心的差異濃縮成:
Workflow
下一步大致可以事先知道
Agent
下一步必須等現在的結果出來才能決定
例如:
固定報表
Fetch
→ Calculate
→ Summarize
→ Export
Workflow。
Debugging
Read error
↓
判斷可能原因
↓
選檔案
↓
修改
↓
Run test
↓
根據新的 failure 再決定
Agent。
所以 Agent 真正增加的不是:
更多 Tool。
而是:
Dynamic Control Flow。
十二、所以 RAG 和 Agent 根本不是互斥選項
這裡又有一個很重要的觀念。
有些人會問:
我要做 RAG 還是 Agent?
但這其實像問:
我要 Database 還是 Backend?
兩者不一定在同一層。
Agent 可能:
Agent
↓
需要知識
↓
Retrieval
↓
取得 evidence
↓
繼續 Decision
所以可以有:
Agent + RAG
也可以有:
Workflow + RAG
甚至:
Workflow
↓
某一小段 Agent
↓
RAG
↓
Deterministic Validation
因此這些名詞比較適合被理解成:
System Components / Control Patterns
而不是只能四選一的產品名稱。
十三、真正實用的選擇順序
如果我們真的要設計一個 AI Application,可以依序問:
Q1
這件事能不能用 deterministic code 解?
如果可以:
→ Code
如果不行:
Q2
核心不確定性是不是自然語言/語意?
如果是:
→ LLM
接著問:
Q3
模型完成任務所需的資訊,
是不是不在目前 Context?
如果是:
→ Retrieval / RAG / Data Tool
接著:
Q4
任務是不是需要多個步驟?
而且步驟大致可以事先定義?
如果是:
→ Workflow
再問:
Q5
下一步是不是必須根據執行結果
在 runtime 動態決定?
如果是:
→ Agent
最後才是:
Q6
一個 Agent 真的不夠嗎?
十四、Multi-Agent 應該是最後才問的問題
Multi-Agent 很容易讓架構看起來很厲害。
例如:
Research Agent
Writer Agent
Reviewer Agent
SEO Agent
Manager Agent
看起來像一個 AI 公司。
但換個角度看:
每增加一個 Agent,就增加:
Context
State
Communication
Coordination
Latency
Cost
Failure Surface
原本:
1 個 Agent
可能只有一條 loop。
現在:
5 個 Agent
除了各自會錯之外,還增加:
A 有沒有正確理解 B?
B 的輸出有沒有被 C 正確使用?
誰負責 final decision?
彼此資料版本一致嗎?
所以 Multi-Agent 不應該是:
Agent 做得不夠好,所以再加幾個 Agent。
十五、什麼情況才真的值得 Multi-Agent?
Multi-Agent 比較合理的情況通常是:
1. 子問題真的可以獨立
例如:
Technical Due Diligence
Legal Review
Market Analysis
三個工作可以平行處理。
2. 不同工作需要大量獨立 Context
如果全部塞給一個 Agent:
Context 過大
互相干擾
拆開才可能合理。
3. Tool / Permission Boundary 不同
例如:
Research Agent:只能讀資料
Deployment Agent:可以操作系統
4. Parallelism 真正帶來價值
如果三個工作可以同時做:
30 min
而不是:
30 + 30 + 30 min
才可能值得增加 coordination。
否則:
一個 Agent 能完成,就先不要 Multi-Agent。
十六、每增加一層架構,都有 Complexity Tax
假設我們從:
LLM
增加到:
LLM + RAG
我們得到 External Knowledge。
但同時增加:
Retrieval Failure
Ranking
Freshness
Context Assembly
從:
Workflow
增加到:
Agent
得到 Dynamic Decision。
但增加:
State
Decision Variance
Tool Selection Error
Loop Control
Observability
Cost
Latency
再到 Multi-Agent:
Coordination
Communication Failure
Shared State
Conflict Resolution
所以每一次架構升級,其實都在做一筆交換:
New Capability
↕
Complexity Tax
真正的問題應該是:
這個新增能力,值不值得新增的 complexity?
十七、不要用錯架構解錯問題
這裡有幾個很常見的錯誤。
推理錯誤 → 加 RAG
如果資料已經在 Context:
Retrieval 不會自動修好 reasoning。
Retrieval 很差 → 換更自主的 Agent
Agent 仍然會吃到錯資料。
只會變成:
Agent 更自主地用錯資料。
固定流程 → 做 Agent
如果:
A → B → C → D
本來就知道:
直接 Workflow 通常比較合理。
規則問題 → 用 LLM
例如:
age >= 18
不需要模型推理。
單一 Agent 不好用 → Multi-Agent
如果問題其實是:
Prompt 不清楚
Tool schema 很差
Context 不足
多五個 Agent 只會把問題放大。
十八、幾個實際例子
Case 1:計算退款金額
需求:
根據訂單金額與退款比例計算
架構:
Code
LLM 都不一定需要。
Case 2:把客服留言分類
需求:
使用者自然語言
→ billing / technical / account
架構:
LLM
因為核心問題是 semantic interpretation。
Case 3:回答公司最新差旅政策
需求:
自然語言問題
+
公司內部最新資料
架構:
Retrieval / RAG
+
LLM
因為真正缺的是 Knowledge。
Case 4:每天產一份固定市場報告
流程:
抓資料
→ Filter
→ Analyze
→ Summarize
→ Validate
→ Export
架構:
Workflow
+
LLM
+
Retrieval
沒有必要讓 Agent 每天重新發明流程。
Case 5:找出測試失敗並修好
不知道 bug 在哪
不知道要讀哪個檔案
修改後結果會影響下一步
架構開始適合:
Agent
+
Tools
因為 Control Flow 本身具有 uncertainty。
Case 6:大型跨領域 Due Diligence
假設真的包含:
Market
Technical
Legal
Financial
各自:
- Context 很大
- 工具不同
- 可以平行
- 有明確整合方式
這時才可能合理考慮:
Multi-Agent
但仍然不是預設答案。
十九、實際系統通常是混合架構
真正 Production System 常常長這樣:
Deterministic Input Validation
↓
Retrieval
↓
LLM Decision
↓
Known Workflow
↓
Agent Decision Point
↓
Tool
↓
Deterministic Validation
↓
Response
也就是:
Deterministic where possible, probabilistic where necessary.
這比:
全部都給 Agent。
更容易控制。
二十、Agent 最適合被放在「不確定的決策點」
這是我認為很實用的一個設計原則。
假設整個流程:
A → B → ? → D → E
只有:
?
需要根據環境決定。
那就沒有必要把:
A B D E
全部交給 Agent。
可以設計成:
Workflow
↓
Agent Decision
↓
Workflow
因此「Agent Architecture」並不代表:
Agent 控制所有事情。
更合理的問題是:
哪幾個 decision point 真的需要模型具有 agency?
二十一、在增加架構之前,先回答三個問題
每一次想加入:
RAG
Workflow
Agent
Multi-Agent
之前,可以先問:
1. 它到底解決哪個現有 Failure?
如果說不出來:
先不要加。
2. 加完之後怎麼證明真的變好?
例如:
Task Success Rate ↑
Retrieval Accuracy ↑
Human Intervention ↓
如果沒有 evaluation:
很難知道只是架構變複雜,還是真的變好。
3. 它會新增哪些 Failure Modes?
例如加入 Agent:
loop failure
tool misuse
state drift
cost increase
這些是否值得?
二十二、最低必要複雜度不是「永遠選最便宜」
Minimum Necessary Complexity 也不是:
永遠做最簡單版本。
真正意思是:
選擇能滿足 Task Requirements 的最小 architecture。
假設業務真的要求:
自動處理大量 open-ended troubleshooting
Workflow 做不到。
那 Agent 就不是「過度設計」。
它是必要複雜度。
反過來:
如果:
五條 if / else
就能解決:
Agent 就是多餘複雜度。
二十三、可以把整個選型濃縮成一條 Decision Tree
任務可以明確寫成規則?
│
├─ Yes → Deterministic Code
│
└─ No
    ↓
需要語言/語意推理?
│
├─ Yes → LLM
│
└─ 視問題使用傳統系統
    ↓
LLM 缺少完成任務所需的外部/最新/私有資訊?
│
├─ Yes → Retrieval / RAG / Data Tool
│
└─ No
    ↓
需要多個已知步驟?
│
├─ Yes → Workflow
│
└─ No
    ↓
下一步必須根據 runtime observation 動態決定?
│
├─ Yes → Agent
│
└─ No → 保持較簡單架構
    ↓
一個 Agent 無法合理處理,
而且子問題真的可獨立/平行?
│
├─ Yes → Consider Multi-Agent
│
└─ No → Single Agent
這不是絕對公式。
但它可以幫助我們避免一件事情:
在還不知道問題是什麼之前,就先選了一個看起來最厲害的架構。
二十四、真正的 Architecture Thinking
從第一篇一路走到這裡,其實可以看到一個轉變:
一開始我們可能會問:
哪個模型最好?
後來變成:
Prompt 怎麼寫?
再往後:
要不要 RAG?
接著:
要不要 Agent?
但真正做 AI Application 時,更好的問題其實是:
Task 是什麼?
↓
哪裡存在 uncertainty?
↓
目前最簡單的系統缺什麼能力?
↓
增加哪一層剛好能補這個 gap?
↓
怎麼驗證新增複雜度值得?
這就是:
Architecture Thinking。
二十五、如果最後真的選了 Agent,下一個問題才開始
如果經過前面的判斷,我們最後得到:
這個任務確實需要 Agent。
下一個問題就不是:
用哪個 Agent Framework?
而是:
這個 Agent 到底要靠什麼東西維持一個可運作的閉環?
上一篇已經看到:
Goal
↓
State
↓
Decision
↓
Action
↓
Observation
但 State 要放什麼?
Tool 怎麼讓模型使用?
跨多個 step 的資訊怎麼保存?
Memory 和 Context 又有什麼不同?
這就是下一篇 Article 08 要真正拆開的問題: