Agent 不只是 LLM:State、Tools、Memory 如何組成可運作系統
上一篇我們做了一個重要的選擇:
不是每個問題都需要 Agent。
如果:
Code
可以解,就先用 Code。
如果需要語意理解:
LLM
如果缺外部知識:
Retrieval / RAG
如果流程大致知道:
Workflow
只有當:
下一步必須根據 runtime 的結果動態決定
Agent 才真正開始有價值。
但一旦我們決定:
這個問題確實需要 Agent。
下一個問題就來了。
前一篇的 Agent loop 是:
Goal
↓
Observe
↓
Decide
↓
Act
↓
Observe Result
↓
Continue or Stop
看起來很簡單。
但如果真的把它寫成系統,很快就會遇到三個問題:
系統怎麼知道現在做到哪裡?
↓
State

模型怎麼對外做事情?
↓
Tools

前面發生過的事情怎麼保留下來?
↓
Memory
這三個東西,才讓:
LLM
變成一個能持續運作的 Agent system。
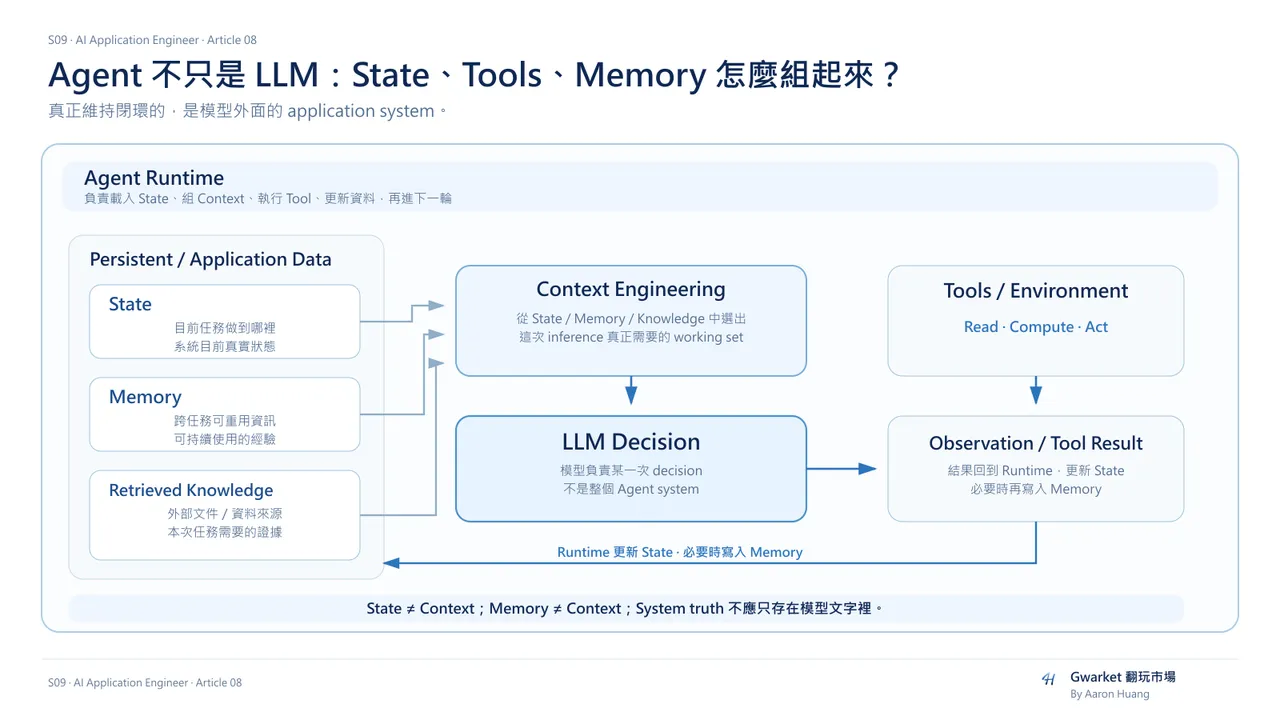
一、先拆掉一個誤會:Agent 的「腦」不是整個 Agent
很多 Agent 架構圖會把中間畫成:
LLM
旁邊接:
Tools
Memory
於是很容易產生一個印象:
Agent 就是一個比較會思考的 LLM。
但實際系統比較接近:
                 ┌──────────────┐
                 │     State    │
                 └──────┬───────┘
                        ↓
Observation → Context → LLM
                        ↓
                    Decision
                        ↓
                      Tool
                        ↓
                    Result
                        ↓
                  Update State
                        ↓
                     Memory
LLM 很重要。
但它通常只是:
某一次 decision 的 reasoning component。
真正維持任務持續運作的,是外面的 application system。
二、為什麼 LLM 自己無法維持一個 Agent?
假設我們要求:
幫我把測試失敗修好。
第一輪:
User:
Fix the failing tests.

↓

LLM:
先跑 tests。
Tool 執行:
run_tests()
得到:
12 passed
2 failed
第二輪模型需要知道:
Goal 是什麼?
剛剛跑過什麼?
結果是什麼?
哪些 test failed?
下一步應該做什麼?
問題是:
LLM 本身並不天然擁有一個永久存在的:
task object
它收到的是:
這一次 inference 的 input
然後產生:
這一次 inference 的 output
所以下一輪如果什麼都沒有重新提供:
模型不會神奇地知道:
我們剛剛跑過 tests。
這就是為什麼 Agent 需要:
State。
三、State 是「任務現在的真實狀態」
State 可以先用一句話理解:
State 是 application 持有的、描述目前任務進度與環境狀態的資料。
例如:
Goal:
修復 login test

Current State:
- 已讀 authentication.py
- 已執行 tests
- 12 passed
- 2 failed
- failure: token expired
- refresh logic 尚未修改
下一輪 Decision 不應該從:
空白
開始。
而應該從:
Current State
繼續。
所以:
Decision = f(Current State, Observation, Goal)
這比:
Decision = f(User Prompt)
更接近 Agent。
四、State 不只是 Conversation History
這裡很容易把 State 理解成:
把聊天紀錄全部保存。
但真正的 State 可以包含很多不是自然語言對話的東西。
例如 Coding Agent:
task_id
current_goal
files_read
files_modified
test_results
current_branch
failed_attempts
pending_actions
last_tool_result
Travel Agent:
destination
travel_dates
budget
selected_flights
rejected_hotels
current_itinerary
booking_status
Research Agent:
research_question
queries_completed
sources_found
claims_supported
claims_conflicted
open_questions
所以 State 更接近:
Application Data Model
而不是單純:
Chat History。
五、State 讓 Agent 不需要每一步重新猜
如果沒有明確 State,系統很容易變成:
LLM:
我記得剛剛好像做過……
這其實非常危險。
因為模型開始用自然語言「推測」系統狀態。
例如:
模型:
我已經修改完成。
但實際檔案:
根本沒改。
或者:
模型:
所有 tests 都通過。
但真實狀態:
integration test 根本還沒跑。
所以重要資訊不應只存在:
模型說過的文字
而應該存在:
System State
例如:
{
  "tests_run": true,
  "passed": 12,
  "failed": 2
}
這就是:
不要讓模型自己發明 system truth。
六、State 和 Context 完全不是同一件事
這是 Agent architecture 裡非常重要的一條界線。
State
是:
系統目前持有什麼資訊。
Context
是:
這一次 inference,你決定把哪些資訊提供給模型。
假設 State 有:
100 個 tool results
30 個 files
20 次 decision
5 個 failed attempts
這些全部都可以存在 application state。
但下一輪 LLM 不一定需要全部看到。
真正送進 Context 的可能只有:
Current Goal

Relevant File

Last Test Result

Important Constraints

Current Plan
所以:
State
≠
Context
更精確地說:
State
↓
Context Engineering
↓
Relevant Context
↓
LLM
這和 Article 02 談的 Context Engineering 就接起來了。
七、不是所有 State 都應該塞進 Context Window
如果每一次 Agent loop 都做:
把所有歷史資料全部塞進 Prompt
很快會出現:
- token 越來越多
- latency 越來越高
- cost 越來越高
- irrelevant information 越來越多
- important information 反而更難被注意
所以 Agent 系統通常需要做一件事情:
從 State 中選出現在 Decision 真正需要的資訊。
也就是:
Large State
↓
Select / Summarize / Retrieve
↓
Working Context
↓
LLM
因此:
Context Engineering 並沒有因為 Agent 出現而消失。
反而更重要。
八、Tool 是 Agent 與 Environment 之間的介面
有了 State,Agent 知道:
現在在哪裡。
但它還需要:
對外做事情。
這就是 Tools。
上一篇 Article 04 已經談過:
Tool Calling
模型可能輸出:
{
  "tool": "run_tests",
  "arguments": {
    "scope": "auth"
  }
}
但在 Agent 系統裡,Tool 的角色可以看得更清楚:
State
↓
LLM Decision
↓
Tool
↓
Environment
↓
Tool Result
↓
Observation
↓
Update State
Tool 其實是:
Agent 可以感知或改變 environment 的 interface。
九、Tool 不只是「執行 Action」
有些 Tool 是用來:
Read
read_file
search_web
query_database
get_order
它們主要產生:
Observation
有些 Tool 是:
Write / Act
write_file
send_email
update_ticket
create_booking
它們會改變:
Environment
也有些 Tool 是:
Compute
calculator
run_code
run_tests
它們把一個問題交給 deterministic system。
所以 Tool 不只是:
Agent 的手。
它也可能是:
Agent 的眼睛、計算器、資料入口。
十、好的 Tool Interface 會直接影響 Agent 的可靠性
假設我們給 Agent 一個 Tool:
do_everything(input)
模型必須自己猜:
這個 input 要怎麼寫?
會做什麼?
結果代表什麼?
這會增加 ambiguity。
如果改成:
search_orders(
  customer_id,
  date_range
)
以及:
request_refund(
  order_id,
  reason
)
模型的 Action Space 就比較清楚。
所以 Agent system design 很大一部分其實是:
設計好的 Tool Interface。
包括:
Tool Name
Description
Input Schema
Output Schema
Error Contract
Tool interface 越清楚:
模型越容易做正確 decision。
十一、Tool Result 不應直接等於「任務成功」
假設:
send_email()
回傳:
200 OK
只能證明:
API call 成功。
它不代表:
Email 內容正確
寄給正確的人
任務已經完成
同樣:
run_tests()
成功執行。
不代表:
tests passed
所以 Tool Result 必須變成:
Observation
然後系統重新判斷:
這個結果對 Goal 代表什麼?
這也就是:
Act
↓
Observe
↓
Decide Again
真正形成閉環的地方。
十二、那 Memory 又是什麼?
如果 State 是:
現在這個任務做到哪裡。
Memory 可以先理解成:
系統希望跨時間保留下來、未來可能再次使用的資訊。
例如:
今天 Agent 幫使用者規劃旅行。
State:
目前正在找東京飯店
已比較 12 家
剩 3 家候選
任務完成後:
這些不一定需要永遠保留。
但可能有某些資訊值得留下:
User prefers:
- non-smoking room
- near MRT
- budget around JPY 20,000
下一次旅行:
這些資訊可能再次有價值。
這就比較接近:
Memory。
十三、State 和 Memory 的差別
可以先用這個方式區分:
| State | Memory | |
|---|---|---|
| 主要用途 | 完成現在任務 | 幫助未來任務 |
| 時間範圍 | current execution | across executions |
| 內容 | step、tool result、progress | reusable knowledge / preference / experience |
| 是否全部給模型 | 不一定 | 更不一定 |
| 誰管理 | application | application / memory system |
例如:
State:
目前第 4 步
API call failed
準備 retry
Memory:
這個 API 在 rate limit 時應降低 batch size
兩者不是完全不能重疊。
但用途不同。
十四、Memory 也不是「把所有聊天都存起來」
如果 Memory 的策略是:
Everything → Save Forever
很快就會出問題。
例如:
過期資訊
錯誤推論
互相矛盾的偏好
重複資料
無關資訊
所以 Memory system 真正困難的問題其實不是:
怎麼存?
而是:
What to remember?
When to retrieve?
What to update?
What to forget?
也就是:
Memory Management。
十五、Memory 通常需要兩個動作:Write 與 Read
最簡單可以拆成:
Memory Write
以及:
Memory Read
Memory Write
任務過程中:
Observation
↓
Worth remembering?
↓
Yes
↓
Store
Memory Read
下一次 Decision:
Current Task
↓
Relevant memory?
↓
Retrieve
↓
Context
↓
LLM
所以 Memory 不應該只是:
database
它其實還需要:
selection
retrieval
update
十六、Memory 和 RAG 看起來很像,差在哪?
這兩個常常在 implementation 上使用類似技術。
例如都可能:
embed
↓
store
↓
retrieve
但概念上的來源不同。
RAG
通常回答:
外部世界有哪些知識是模型現在需要的?
例如:
公司政策
產品文件
研究報告
Knowledge Base
Memory
通常回答:
這個系統過去互動或執行中,有哪些資訊值得未來繼續使用?
例如:
user preference
previous decision
past failure pattern
task history
所以:
RAG
比較像:
External Knowledge
Memory 比較像:
Persisted System Experience
技術可以重疊。
但 semantic role 不一樣。
十七、Memory 和 Context 也不能混在一起
再整理一次:
Memory
Stored information across time
State
Current task information
Context
Information given to the model right now
三者的關係可能是:
State ──────┐
            │
Memory ─────┼→ Context Engineering → Current Context → LLM
            │
Retrieved ──┘
Knowledge
所以 Context 不是資料來源本身。
Context 是:
這一次 inference 的 working set。
這是非常重要的架構觀念。
十八、一個完整 Agent Loop 現在長什麼樣?
現在可以把前面的東西全部組起來。
Goal
↓
Load State
↓
Retrieve relevant Memory
↓
Get relevant external Knowledge
↓
Build Context
↓
LLM Decision
↓
Select Tool
↓
Execute Tool
↓
Observe Result
↓
Update State
↓
Write Memory if needed
↓
Continue or Stop
這時你會發現:
LLM 只在其中一小段:
Build Context
↓
LLM Decision
Agent 真正的 architecture 大部分其實都在模型外面。
十九、Agent Runtime 才是真正把這些東西串起來的地方
誰負責:
讀 State?
誰負責:
建立 Context?
誰負責:
把 Tool Result 寫回 State?
誰負責:
下一輪再呼叫模型?
答案通常不是 LLM。
而是:
Agent Runtime / Application Runtime。
可以想成:
while not done:

    state = load_state()

    context = build_context(
        state,
        retrieve_memory(state),
        retrieve_knowledge(state)
    )

    decision = llm(context)

    result = execute_tool(decision)

    state = update_state(
        state,
        result
    )

    save_state(state)
這只是概念 pseudo-code。
但它很接近 Agent system 真正的骨架。
二十、所以 Agent Framework 到底在幫你做什麼?
到了這裡,才比較容易理解:
Agent Framework
到底存在的原因。
它通常不是提供:
更聰明的模型。
而是在幫你處理:
State Management
Tool Registry
Tool Execution
Message / Context Assembly
Loop Control
Memory Integration
Tracing
也就是:
模型外面的 Agent Runtime infrastructure。
所以不同 framework 的差異,很多時候不是:
誰的 LLM 比較聰明。
而是:
誰怎麼管理這整個 execution loop。
二十一、但不要因為有 Framework,就把所有東西交給 Framework
這裡又回到上一篇:
Minimum Necessary Complexity。
如果你的系統只有:
User
↓
LLM
↓
Database Search
↓
Answer
可能根本不需要複雜 Agent Framework。
你完全可以自己寫:
retrieve()
generate()
validate()
只有當:
State
Tools
Memory
Dynamic Decisions
Multiple Steps
開始變複雜時:
Framework 才可能真的幫你減少 orchestration cost。
二十二、最重要的不是「有沒有 Memory」,而是資料責任在哪裡
很多 Agent Demo 會強調:
我有 Memory。
但 Production System 更應該問:
誰寫入?
寫什麼?
什麼時候更新?
哪個資料才是真實來源?
衝突怎麼處理?
什麼時候失效?
例如:
User says:
我喜歡靠近捷運的飯店。
系統可能記成 preference。
但如果下一次使用者說:
這次我要住山上,不用靠捷運。
Agent 不能因為:
Memory = near MRT
就覆蓋當前 Task Requirement。
因此一般來說:
Current explicit task constraint
應該比:
Old memory
更有優先權。
Memory 是 context source。
不是絕對真理。
二十三、同樣地,State 也需要 System of Record
假設 Tool Result 說:
booking_status = failed
但模型輸出:
Booking completed successfully.
哪一個是真實狀態?
應該是:
Tool / System State
而不是:
LLM narrative
所以 Production Agent 最重要的一條原則之一是:
System truth 應該由可靠的 application state / external system 保存,而不是存在模型生成的文字裡。
二十四、這也是為什麼 Agent Engineering 很像 Software Engineering
做到這裡會發現:
真正的 Agent Engineering 不只是:
Prompt Engineering
它開始涉及:
Data Model
State Machine
API Design
Tool Contract
Persistence
Retrieval
Error Handling
Observability
Evaluation
LLM 只是其中一個:
Probabilistic Decision Component
所以:
Agent Engineer 不是只會讓模型回答。
而是:
知道怎麼把一個 probabilistic model 放進可管理的 software system。
二十五、把 Article 06–08 串起來
現在三篇其實形成一條很清楚的線:
Article 06
回答:
Agent 是什麼?
Goal
→ Observe
→ Decide
→ Act
→ Feedback
Article 07
回答:
什麼時候真的需要 Agent?
Minimum Necessary Complexity
Article 08
回答:
Agent 真正怎麼運作?
State
+
Tools
+
Memory
+
Runtime
接下來就剩最後一個非常重要的問題。
二十六、Agent 能做事之後,下一個問題不是「還能做什麼」
一旦 Agent 有:
State
Tools
Memory
Dynamic Decisions
它就開始真的具有:
Agency
這時真正危險的問題不是:
能不能多接幾個 Tool?
而是:
它到底可以做哪些 Action?
哪些 Action 需要 Permission?
什麼時候要 Human Approval?
怎麼避免 Loop 一直跑?
什麼情況必須 Stop?
這些就不再只是:
Agent Capability
而是:
Agent Governance。
這也是 S09 最後一篇 Article 09 要處理的問題: