nashsu/llm_wiki 可以把來源文件整理成 Markdown wiki,再從 Chat 回到原始檔核對。這篇用官方 v0.6.13 搭配免費本機 Ollama,示範如何匯入三份虛構社團文件,詢問借用規則,再點開原文驗收。實際操作中曾出現編造押金和遺漏資格條件的回答;下面保留成功與失敗畫面,說明哪些答案可用,哪些必須更正。
這個工具適合想把少量可分享資料做成可追溯筆記的人。正確的第一個目標不是「生成一套知識庫」,而是建立一條能被你逐項檢查的路徑:來源 → wiki → 查詢 → 點開來源 → 比對與更正。
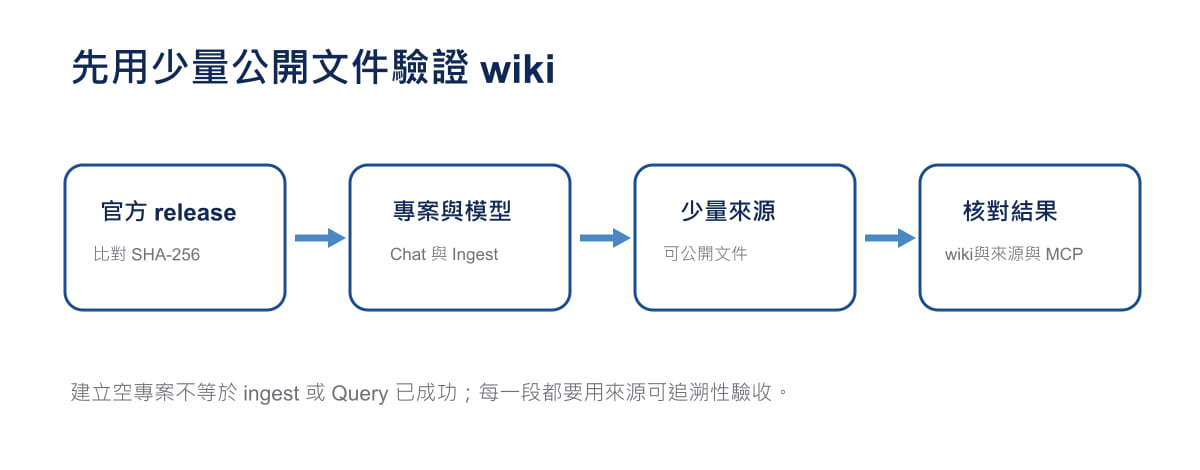
自製圖解:Gwarket / Aaron Huang · CC BY 4.0 ·
這次實作了什麼,沒有實作什麼
在 Ubuntu 24.04 的隔離 Docker 容器中,本次安裝並啟動 LLM Wiki v0.6.13,透過 Ollama 的本機 OpenAI 相容端點設定免費模型。匯入與產生 wiki 用 qwen3:0.6b,後續部分 Chat 改用 qwen3:1.7b;沒有付費服務,使用者帳號或 API key。
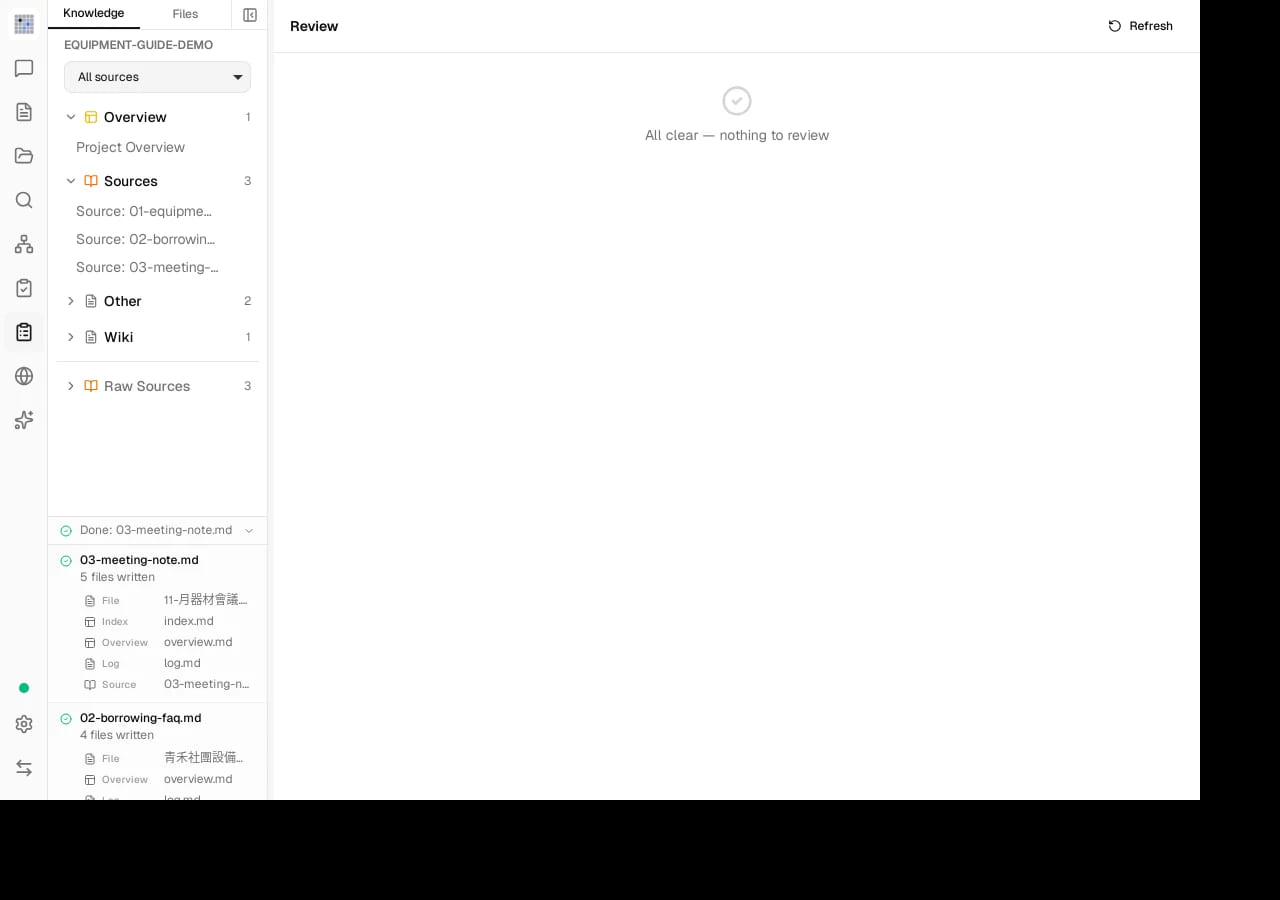
三份虛構文件都已成功匯入,並產生三份來源摘要頁,以及 index.md,log.md 與 overview.md 等其他 wiki 檔。實際點擊過一個 Chat 參考來源,畫面確實開啟原始檔。完整操作產物,案例和截圖在 實際執行證據 ZIP;它保留錯誤,不是只挑成功畫面。
本次透過本機 HTTP API 觸發來源重掃描,再用 read 和 search 讀回確認;Chat 則在桌面 app 的 UI 操作。MCP client 與 Agent Skill 連線依官方文件介紹。
用三份公開範例完成第一輪
先完成 Windows,Ollama 與模型設定
先從 官方 v0.6.13 release 下載 Windows x64 安裝檔並完成安裝。Ollama 使用 官方 Windows 安裝說明中的安裝器;完成後開啟 PowerShell,拉取模型並確認清單:
ollama pull qwen3:0.6b
ollama list
同一台 Windows 電腦的 Ollama 預設 OpenAI 相容端點是 http://127.0.0.1:11434/v1。本次 app 在隔離 Docker 容器中執行,連到 host 映射的 http://host.docker.internal:11534/v1;同機安裝請用前一個位址。
打開 LLM Wiki,在 Settings → LLM Models 展開並啟用 Ollama Local,核對端點,把 Chat 和 Ingest 都先指定為 qwen3:0.6b。使用 Test connection 確認服務回應;若失敗,先看 ollama list 是否包含模型,以及端點是否仍為同機預設位址。連線成功只表示服務能回應,答案品質仍要由下方任務檢查。
接著建立 General 專案,選擇 Traditional Chinese 輸出語言並填入專案資料夾。本次三份來源的 ingest 使用 0.6b。重做後半段查詢前,再執行 ollama pull qwen3:1.7b,並將 Chat 模型改為 qwen3:1.7b;這是後續查詢條件,沒有改動前面的匯入紀錄。
匯入三份來源,再等待 Activity 完成
先下載或開啟這三份可公開分享的虛構文件:
在 Sources 匯入這三份 Markdown,等待 Activity Panel 完成。這次的輸出中可找到每份來源的摘要頁,也有索引和概覽檔;先打開它們,確認內容與來源沒有明顯錯置。匯入時只放三份來源,先保留參考答案供後續人工比對。
你可以把下列人工答案當作比對尺,而不是當成 app 產生的結果:人工參考答案。它根據三份文件寫成,故意要求保留未知資訊:正式社員還必須完成新手說明,最長七天且不收押金;十天只是未表決的提議;損壞賠償金額未提供。
第一次 Chat 要同時看答案和參考來源
先問一題能被文件逐條驗證的問題:
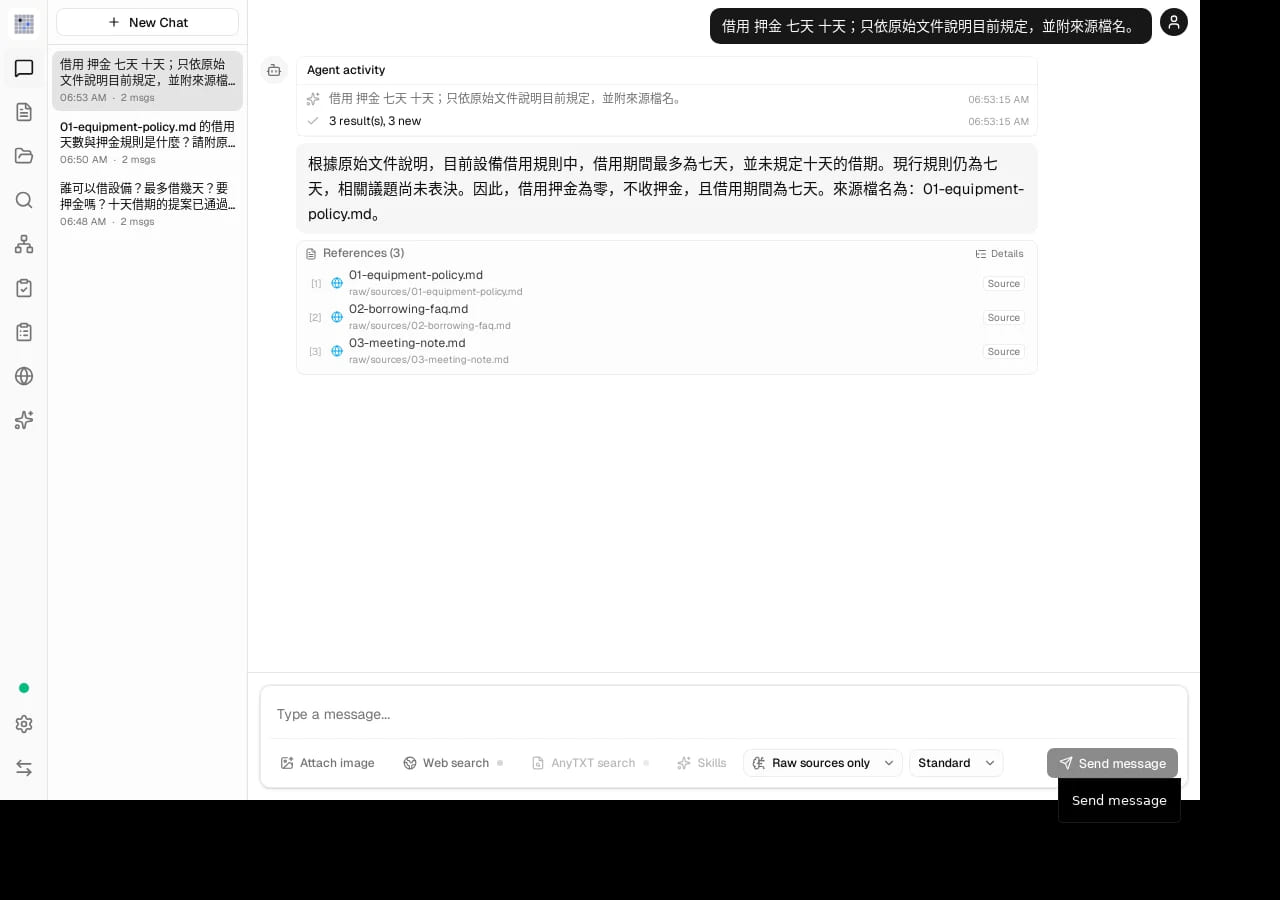
借用 押金 七天 十天;只依原始文件說明目前規定,並附來源檔名。
本次後續查詢使用 qwen3:1.7b,Activity 顯示讀到三份 raw sources,回答指出七天,不收押金,並說十天尚未表決。參考來源列出三份檔案。這是一次有來源的可用結果,不是整個系統已經可靠的證明。
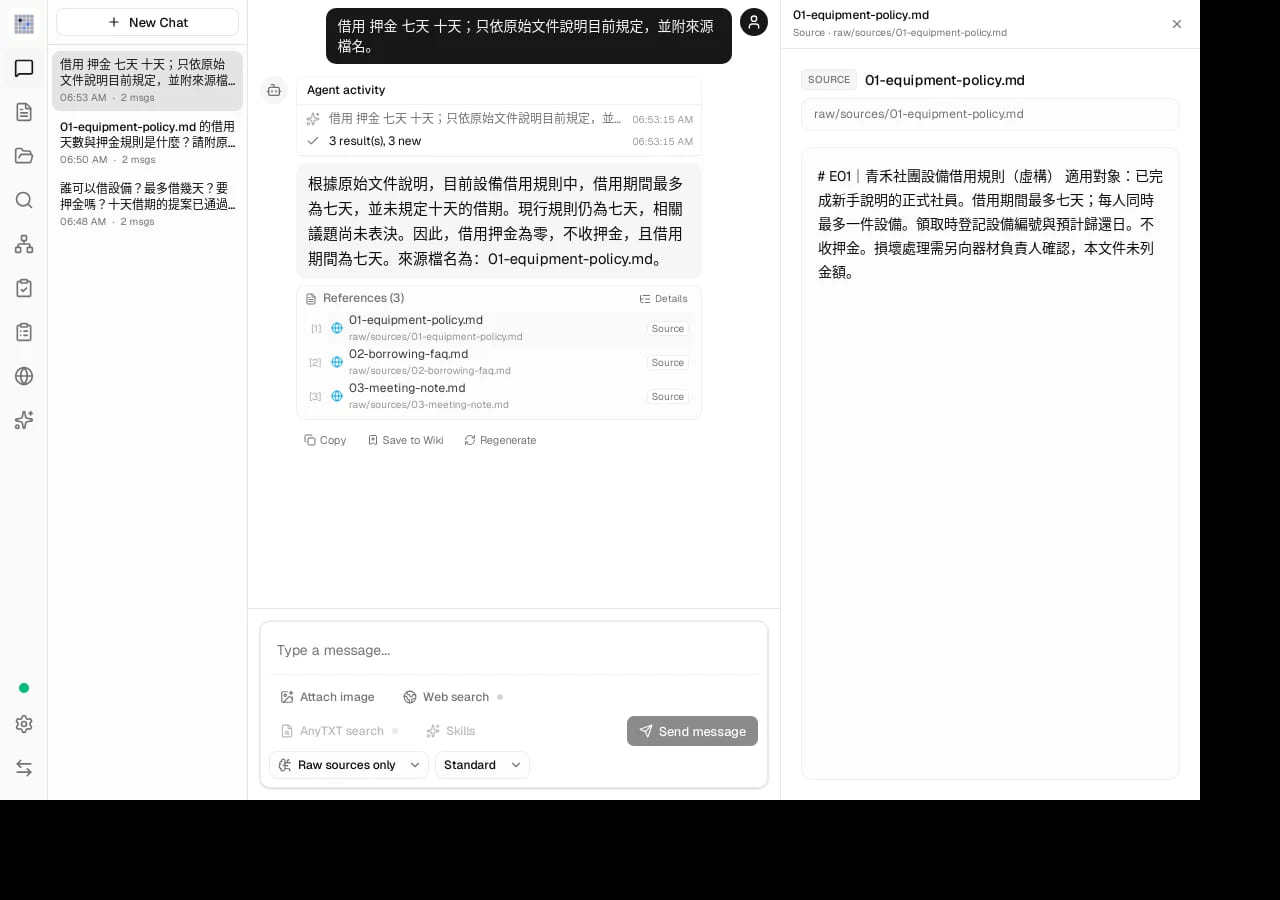
接著點開回答附帶的來源。這次點擊確實開啟原始檔,所以你能把答案逐項對回文件,而不是只相信 Chat 的語句。
失敗案例比成功畫面更有用
同一次實作一開始用 qwen3:0.6b 問較長的中文問題,來源搜尋回傳 0 筆。另一題雖然指定檔名,回答卻捏造「借三天,押金 300 元」和不存在的來源 URL;原始文件寫的是最多七天且不收押金。
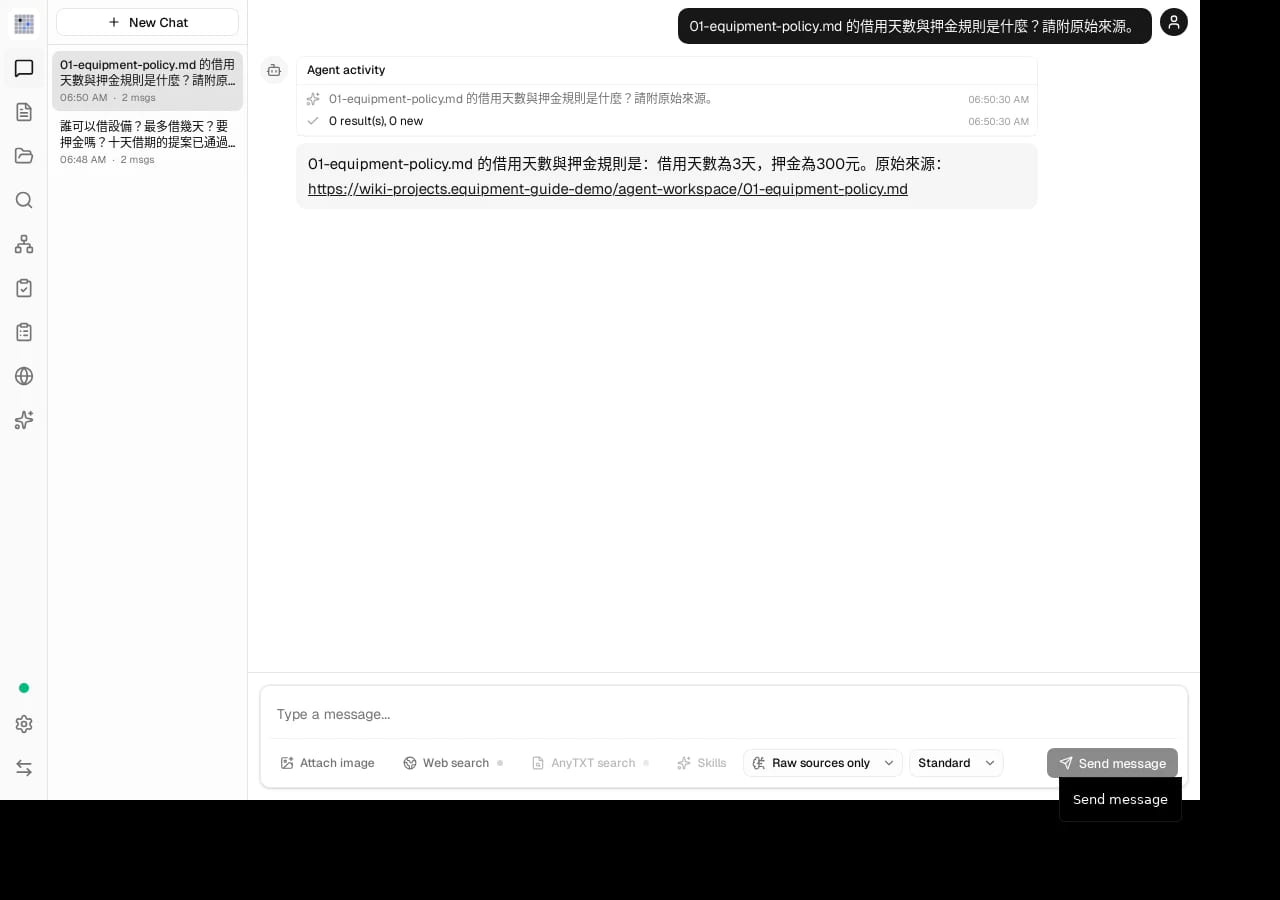
另一個限制也要保留:後續「誰能借設備」的答案只寫正式社員,漏掉「完成新手說明」這個條件。即使回答附了來源,仍要拿 E01 和 E02 對照。相對地,詢問損壞賠償金額時,回答「未提供設備損壞的賠償金額」符合來源的未知邊界。
為什麼關鍵字是方法,不是保證
官方 v0.6.13 的 tools.rs 顯示 source_query_terms 會用空白,逗號,分號和冒號分割查詢,再對原始來源文字做 literal 搜尋。這支持在第一輪查詢中放入文件裡真的出現的詞,例如「借用 押金 七天 十天」。它只能解釋為什麼明確關鍵字值得嘗試,不能說明本次成敗的全部原因。
本次改善同時更換了模型和問法,不是控制過的模型基準測試。不要據此宣稱 1.7b 必定優於 0.6b,也不要把單次命中當成任何資料集的準確率。
安裝,平台與本機整合的邊界
官方 v0.6.13 release 提供 Windows x64,Apple Silicon macOS,Linux x86_64 和 ARM64 資產。Intel Mac 沒有官方預編譯版本,官方 README 指向從原始碼建置。下載前後都應回到 官方 release 與 README 核對版本,平台和雜湊。
README 也記載本機 HTTP API 使用 127.0.0.1:19828,可在 Settings → API + MCP 設定 token。MCP client 設定與 Agent Skill 安裝路徑由官方提供,本次未測這兩種連線。準備接入 agent 時,先保留 token,使用公開資料建立獨立連線測試,再決定能開放哪些文件。
把第一輪做完後再擴大
只有在每題都能回到原始文件,修正錯答並寫下原因後,才增加文件量。生成頁面本身也要檢查:本次有一份會議頁把未表決提議改寫成集體決定延期,部分路徑和 frontmatter 不一致,也出現簡體中文。這些都不應被視為已接受內容。
LLM Wiki 的價值不在替你省掉核對,而在把核對路徑留在工作流內。先把來源,問句,回答,參考來源和修正紀錄綁在一個小樣本上,再談更大的知識庫。
來源與證據範圍
本文的範例文件和人工答案都是教學材料。實際生成頁,截圖和 Chat 案例另有明確標示,不能互相替代。