這份快照最有用的訊號,不是哪個 AI 產品「最紅」,而是讀者在接觸一個名稱後最先補問什麼:費用與方案、怎麼開始、它是什麼、能不能用中文。以 28 個預選 seed 的 Google 搜尋建議來看,先把一個工具講清楚、標出成本和入口,通常比急著做產品排名更接近讀者的下一步。
2026 年 11 月 8 日,我們以台灣 locale 收集 28 個 AI 相關 seed 的 Google Autocomplete 建議。資料共 7,248 列原始結果,跨 seed 全域去重後為 7,237 個建議詞。這不是搜尋量、使用者人數或市占排行;它只是一個固定採樣方法下,搜尋框當時回傳的語句快照。
先別把搜尋建議當成市場排名
Google 搜尋建議是輸入提示,不會提供每個詞被查了多少次,也不告訴我們是哪些人、為何搜尋,更不能由 18 個 seed 推到「18 倍需求」。這次清單同時有產品、公司與概念,例如 ChatGPT、Claude、OpenAI、Anthropic、MCP、AI agent;它們不是同一類工具,不能放進同一張人氣榜。
這個限制反而決定了資料的正確用法:它適合找出內容入口該優先回答的問題,不適合判定市場規模或宣稱趨勢上升。若下季沿用同一套 seed、locale、擷取方式與分類規則,才可能比較相同方法下的變化;單次採樣不能說明成長方向。
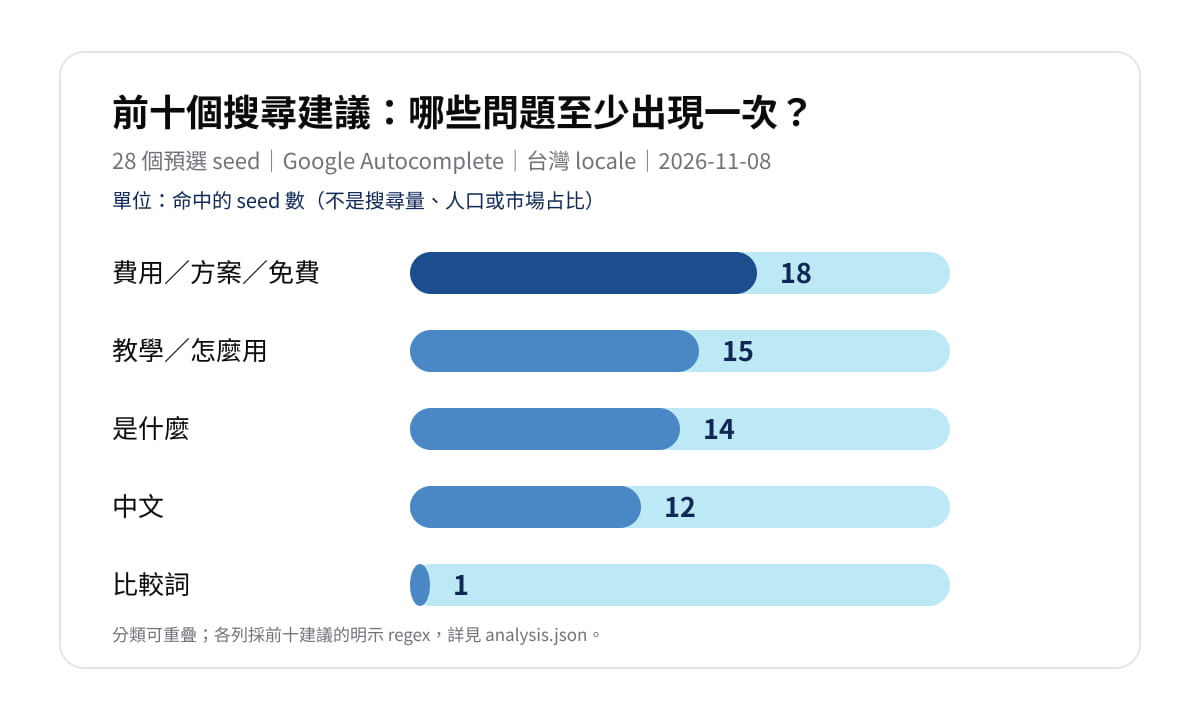
前十個建議反覆出現的是「先能用,再談進階」
為了讓結果可重現,我們只在每個 seed 的「seed 加一個空白」前十個建議中,以明示 regex 判斷是否至少出現一次。分類可以重疊,因此各列不是互斥加總,也不代表所有建議的比例。
| 明示分類 | 出現於前十的 seed 數 | 判斷字詞範圍 |
|---|---|---|
| 費用/方案/免費 | 18/28 | 費用、方案、免費、價格、price、pricing、cost、free、plan |
| 教學/怎麼用 | 15/28 | 教學、怎麼用、how to、tutorial |
| 是什麼 | 14/28 | 是什麼、what is |
| 中文 | 12/28 | 中文 |
| 比較詞 | 1/28 | 比較、差別、vs、versus |
這不是在判定哪一類「最多人搜」,而是回答一個較窄的問題:有多少個 seed 的首屏建議至少出現過該類字詞。分類範圍不同,統計結果也可能不同。本文採用上表的明示規則,讀者可以利用附檔重新執行或更換規則,並在比較結果時先核對定義是否一致。
幾個樣例說明:內容入口要回答哪一題
ChatGPT 的前十包含「chatgpt 費用」「chatgpt 方案」與「chatgpt 中文」;Claude 有「claude 中文」「claude 方案」「claude 費用」和「claude 是什麼」。這類入口頁不該只解釋功能,也應直接交代方案資訊的查核時間、官方入口,以及繁中支援要以哪個產品表面為準。
Codex 的前十出現「是什麼、下載、cli、教學、費用」;Claude Code 包含「教學、費用、cli、install、下載、安裝、價格」;Gemini CLI 包含「教學、安裝、是什麼、費用、安裝 windows」。這些字串足以支持「安裝、入口、教學與成本是值得優先覆蓋的題目」,卻不足以說多數台灣人仍停在安裝階段,或認定任何產品正在成長。
比較詞在此窄規則中只命中 ChatGPT Work,樣例有「chatgpt work codex 差別」與「chatgpt work vs codex」。這是值得安排比較頁的線索,不是「比較需求很少」的市場結論:比較可能以「推薦」「替代」或完全不同句型出現,而本文沒有把那些句型納入前十的比較詞規則。
Antigravity 的前十中多次出現「antigravity a1」。同名雜訊提示我們不能假設每一個補全都在問同一個 AI 產品;本文只標記這個混淆風險,沒有為此擴大新的調查,也不把它計入某項產品功能或需求的證據。
7,237 個去重詞適合做什麼,不適合做什麼
完整採集不是只有前十:每個 seed 另以「seed 加空白再加 a 到 z」收集建議。這形成 7,248 列原始資料,去重後有 7,237 個不同詞。依全量詞用另一組規則分類時,可見「價格與方案」343 列、「比較與選擇」283 列、「安裝與下載」168 列、「操作與教學」149 列、「排錯與限制」111 列與「登入與帳號」58 列。這些是可尋找長尾題材的索引,不是彼此互斥的分布:同一詞可命中多條規則,且 seed 的選擇和字母展開會影響涵蓋面。
若要寫教學,較好的順序不是把 7,237 個詞全變成頁面,而是先挑一個已存在或可查證的產品入口,依序回答:它是什麼、從哪裡開始、費用或方案該去哪裡核對、第一次使用要做哪件可驗收的小事。接著再從完整詞表找具體困惑,例如安裝、登入、限制或比較,確認官方文件能支持後才拆成獨立題目。這能讓搜尋建議成為選題假設,而不是假裝成需求量證明。
從一個詞到一篇教學,中間還有三道檢查
第一道是語意檢查。Autocomplete 只是把可能的續寫排在一起;「下載」可能是想找官方安裝檔,也可能是找非官方轉載頁;「免費」可能問方案,也可能只是想規避付費。因此,詞表只能提出問題,不能替文章預先回答問題。準備題目時,先保留原始查詢,再找官方文件確認它對應的產品表面、作業系統、方案與日期。
第二道是頁面邊界檢查。像「Codex 教學」和「Codex 費用」可以共享導覽,卻未必應被塞進同一篇長文;前者的讀者需要開始步驟與可驗收成果,後者需要可核對的方案條件與更新日期。同樣地,「ChatGPT Work 與 Codex 差別」是比較意圖,不能用一篇泛泛的產品介紹取代。先決定讀者要完成什麼,再選擇是入口頁、任務教學、費用頁或比較頁,能避免把資料詞彙誤當成網站架構。
第三道是時效檢查。搜尋建議本身沒有產品版本、價格或官方支援範圍;這些資訊進入正文前,都必須在發布日重新查看一級來源。若沒有可支持的資料,文章可以明說「請以官方頁面為準」,但不應用模糊推測補上數字。這也是本報告把原始資料、分類規則與編輯判斷分開保存的原因:資料可重跑,判斷可重審,兩者不能互相冒充。
對讀者而言,最有價值的不是看到一份看似精確的榜單,而是能回到原始詞、看見分類規則,並知道下一篇教學究竟回答哪個具體問題。
方法、限制與資料下載
採集日期為 2026-11-08,locale 為 zh-TW / TW,方法是 Google Autocomplete 的預選 seed 加空白,以及 seed 加空白再加 a 到 z。每個 seed 的原始列數約 237 至 268,這是採樣上限與回傳方式造成的範圍,不能用來比較產品熱門程度。Google 可能隨時間、地點與系統調整回傳結果;這份資料也沒有涵蓋所有 AI 名稱、所有語言或所有搜尋句型。
本報告附三個可複查檔案:raw-suggestions.json(完整原始建議列)、seed-counts.csv(各 seed 的列數與去重數)、category-rules.json(全量詞分類規則)。前十分析的 regex 與命中 seed 同時記錄在 analysis.json;下載或引用時應連同採集日期、locale、seed 清單和限制一起保留。
自製圖解:Gwarket / Aaron Huang · CC BY 4.0 ·