Prompt 不是魔法:Structured Output、Tool Calling 與非確定性
前一篇談到 Transformer、Attention 與 Embedding。
理解這些機制之後,下一個實務問題通常是:
既然 LLM 本質上是在預測下一個 Token,我們到底要怎麼讓它穩定地完成工作?
很多人第一個答案是:
把 Prompt 寫得更好。
這沒有錯,但只說對了一部分。
Prompt 可以影響模型的行為,卻不能把一個機率模型變成傳統程式。
當 AI 從聊天工具進入真正的應用系統後,我們真正需要處理的其實是幾個不同層次的問題:
- 怎麼把任務與限制說清楚?
- 怎麼讓輸出具有可被程式使用的結構?
- 模型要怎麼和外部工具互動?
- 為什麼同一個問題可能得到不同答案?
- 如果輸出本來就可能變動,我們又該怎麼測試?
這也是從「會用 ChatGPT」走向「會做 AI Application」的一個重要分界。
一、Prompt 的真正作用:不是下咒語,而是縮小模型的選擇空間
Prompt Engineering 很容易被講得像一套神秘技巧:
只要找到某個神奇句型,模型就會突然變聰明。
但從模型的角度來看,事情其實沒那麼神秘。
LLM 每一步都在根據目前 Context,估計下一個 Token 的可能分布。
所以 Prompt 真正做的事情,是提供更多條件,讓某些輸出變得更合理、某些輸出變得比較不合理。
換句話說:
Prompt 的本質,是約束模型的行為空間。
例如只說:
「幫我分析這個產品。」
模型必須自己猜:
- 要分析市場嗎?
- 要分析產品功能嗎?
- 要分析競爭者嗎?
- 要多長?
- 給誰看?
- 要不要提供建議?
但如果改成:
「你是一名 B2B Product Marketing Analyst。請根據以下產品資料,從 Target Customer、Pain Point、Value Proposition、Competitive Differentiation 四個面向分析,每個面向最多三點;如果資料不足,標記為 insufficient information,不要自行補充。」
模型可選擇的空間就小很多。
因此好的 Prompt 通常不是靠「寫得很長」,而是把幾件事情說清楚:
1. Task
到底要模型做什麼。
例如:
- 摘要
- 分類
- 擷取
- 比較
- 推理
- 改寫
- 產生內容
2. Context
模型完成任務需要知道什麼。
包含:
- 背景
- 使用者需求
- 文件內容
- 前一步結果
- 外部系統提供的資料
3. Constraints
哪些事情不能做,或必須符合什麼限制。
例如:
- 只能根據提供資料回答
- 不知道就標記 unknown
- 不超過 300 字
- 必須使用繁體中文
- 必須輸出指定欄位
4. Output Contract
結果要長什麼樣子。
這一點尤其重要。
因為當 LLM 只是給人閱讀時,「大致正確」可能就夠了。
但如果下一個接收者不是人,而是另一段程式碼,那麼:
「意思差不多」
通常不夠。
二、Structured Output:從「文字」變成「系統可以處理的資料」
假設你要模型判斷一張客服工單。
你期待得到:
類別:退款
緊急程度:高
需要人工處理:是
如果只是給人看,這完全沒問題。
但如果下一步要讓程式自動讀取結果,它可能期待的是:
{
  "category": "refund",
  "priority": "high",
  "requires_human": true
}
兩者對人來說意思差不多。
對程式來說卻完全不同。
這就是 Structured Output 要解決的問題。
自然語言是一個很差的 API Interface
LLM 非常擅長自然語言。
但自然語言本身充滿變化。
例如模型可能回答:
Priority: High
也可能:
This request appears to be high priority.
甚至:
{
  "priority": "urgent"
}
如果你的 downstream system 只接受:
"priority": "high"
那麼意思再接近都可能造成程式錯誤。
因此 AI Application 常常需要把模型輸出限制成某種 schema。
例如:
{
  "category": "billing | technical | account",
  "priority": "low | medium | high",
  "requires_human": true
}
這相當於建立一個:
Model Output Contract
模型不再只是回答問題。
它是在產生另一個系統可以消費的資料。
三、Structured Output 不等於「叫它輸出 JSON」
這裡有一個常見誤區。
很多人會在 Prompt 裡寫:
Please output JSON.
然後看到模型真的輸出 JSON,就認為問題解決了。
但這只是第一層。
真正的系統通常至少還要考慮:
Syntax Validation
它是不是合法 JSON?
Schema Validation
欄位是否存在?
型別是否正確?
例如:
"requires_human": "yes"
可能是合法 JSON,但如果系統期待 Boolean:
"requires_human": true
它仍然是不合法的 application output。
Semantic Validation
就算格式完全正確,內容仍可能不合理。
例如:
{
  "priority": "low",
  "requires_human": false
}
格式沒有任何問題。
但如果原始使用者說:
我的帳號遭到盜用,而且信用卡正在被扣款。
那問題就不在 JSON,而在模型的判斷。
所以:
格式正確 ≠ 結果正確。
Structured Output 解決的是「介面穩定性」的一部分,而不是替代內容驗證。
四、Tool Calling:LLM 不需要自己做所有事情
假設使用者問:
我今天下午三點有沒有會議?
LLM 本身不知道你的 Calendar。
如果直接回答,它只能:
- 使用 Context 裡已有的資訊
- 或猜
更合理的系統設計,是讓模型判斷:
我需要查 Calendar。
然後產生類似:
{
  "tool": "get_calendar_events",
  "arguments": {
    "date": "2026-09-21",
    "time": "15:00"
  }
}
Application 收到這個結果後,才真正去執行 Calendar API。
取得資料後,再把結果送回模型。
模型最後回答:
你下午三點有一場 Project Review。
這就是 Tool Calling 的核心概念。
五、LLM 通常不是 Tool Executor,而是 Tool Decision Maker
這個區別非常重要。
很多架構圖會畫成:
LLM → Tool
看起來像是模型自己呼叫 API。
但實際應用通常更接近:
User
 ↓
Application
 ↓
LLM
 ↓
Tool Request
 ↓
Application
 ↓
External Tool / API
 ↓
Result
 ↓
Application
 ↓
LLM
 ↓
Final Response
也就是:
模型提出它想使用什麼工具,以及需要哪些參數。
真正執行工具的是外部 Application Runtime。
因此 Tool Calling 本質上不是模型突然獲得了超能力。
而是:
我們讓模型可以參與軟體系統的控制流程。
這也是 LLM Application 和單純聊天機器人開始產生巨大差異的地方。
六、Tool Calling 最重要的不是「有工具」,而是 Interface
假設模型有一個搜尋工具:
search(query)
這個 interface 非常寬。
模型必須自己猜:
- query 要多長?
- 用什麼語言?
- 要不要放日期?
- 搜尋的是網頁還是公司資料?
- 結果有幾筆?
如果改成:
search_documents(
  query: string,
  source: "internal" | "web",
  max_results: integer,
  date_after: date | null
)
模型可以做出的選擇就清楚很多。
這和 Prompt constraints 是同一個核心概念:
不要期待模型自己猜對所有事情,而是透過 interface design 縮小錯誤空間。
因此 Tool Calling 做得好不好,不只是模型能力問題。
Tool schema、本身的 description、argument definition,同樣會直接影響成功率。
七、Sampling:為什麼同一個 Prompt 不一定得到同一個答案?
這時候就會碰到另一個 LLM 和傳統軟體很不一樣的地方:
它的輸出具有機率性。
模型在每個 Token 上,都會產生一組候選 Token 的 probability distribution。
概念上可能像:
AI       0.38
model    0.21
system   0.17
agent    0.09
...
接下來系統必須決定:
要選哪一個?
最簡單的方法,是永遠選最高機率的 Token。
但實際生成系統也可能從多個候選中抽樣。
因此模型可能在不同執行中走上不同的文字路徑。
八、Temperature:不是「創意按鈕」,而是調整機率分布
Temperature 經常被簡化成:
Temperature 高 = 有創意
Temperature 低 = 準確
這種說法方便理解,但不夠精確。
Temperature 更接近:
調整候選 Token probability distribution 的集中程度。
Temperature 較低時:
高機率 Token 會更突出。
模型傾向選擇較高機率的結果。
Temperature 較高時:
機率分布會比較平坦。
原本機率較低的 Token 也更可能被選到。
所以更精確的理解是:
Lower temperature
→ narrower output distribution

Higher temperature
→ wider output distribution
這確實可能表現在「更保守」或「更多樣化」上。
但 Temperature 本身不是:
- factuality knob
- intelligence knob
- creativity detector
它只是 sampling configuration 的其中一部分。
九、Top-p:限制模型從多大的候選集合裡抽樣
另一個常見參數是 Top-p。
它的基本概念是:
不要從整個 vocabulary 中抽樣,而是先找出一組累積機率達到指定門檻的 Token,再從這組 Token 中選擇。
例如某一步:
A  0.50
B  0.25
C  0.15
D  0.06
E  0.04
如果 Top-p 設定為 0.9,系統可能只保留:
A + B + C = 0.90
後面的 Token 不參與這次抽樣。
因此:
- Temperature 改變 probability distribution 的形狀
- Top-p 改變 sampling candidate set
兩者都會影響模型輸出的多樣性與穩定程度。
十、為什麼 AI Application 很難用傳統 Unit Test 思維測試?
傳統程式通常可以測:
assert add(2, 2) == 4
輸入一樣。
輸出應該一樣。
但如果測試 LLM:
Input:
Summarize this customer complaint.
第一次可能輸出:
Customer requests a refund because the product arrived damaged.
第二次:
The customer received a damaged product and is asking for a refund.
兩個答案其實都正確。
如果我們測:
assert output == expected_output
第二個答案就會被判定失敗。
這就是 LLM Application 測試很重要的一個思維轉換:
很多時候我們不能測 exact output,而要測 expected behavior。
十一、不要問「答案是不是完全一樣」,而要問「它有沒有違反 Contract」
例如客服分類系統,我們可以測:
Schema
是不是符合:
{
  "category": "...",
  "priority": "...",
  "requires_human": true
}
Allowed Values
category 是否只能是:
billing
technical
account
Business Rules
如果使用者描述帳號被盜:
requires_human == true
Grounding
如果來源資料沒有訂單編號,模型不能自己生成訂單編號。
Tool Behavior
需要最新訂單狀態時,有沒有使用 order lookup tool?
這些通常比檢查整段文字是否完全一樣更有意義。
十二、AI 測試的核心:從 Exact Match 轉成 Invariant
可以把這個觀念理解成:
傳統程式:
Input
↓
Expected Exact Output
LLM Application:
Input
↓
Range of Acceptable Outputs
↓
Required Invariants
Invariant 指的是:
不管模型怎麼表達,都不應該被破壞的條件。
例如:
不能捏造資料
必須輸出合法 schema
重要事件必須 escalated
不能呼叫不存在的 tool
工具參數必須符合 schema
這些才是系統真正關心的事情。
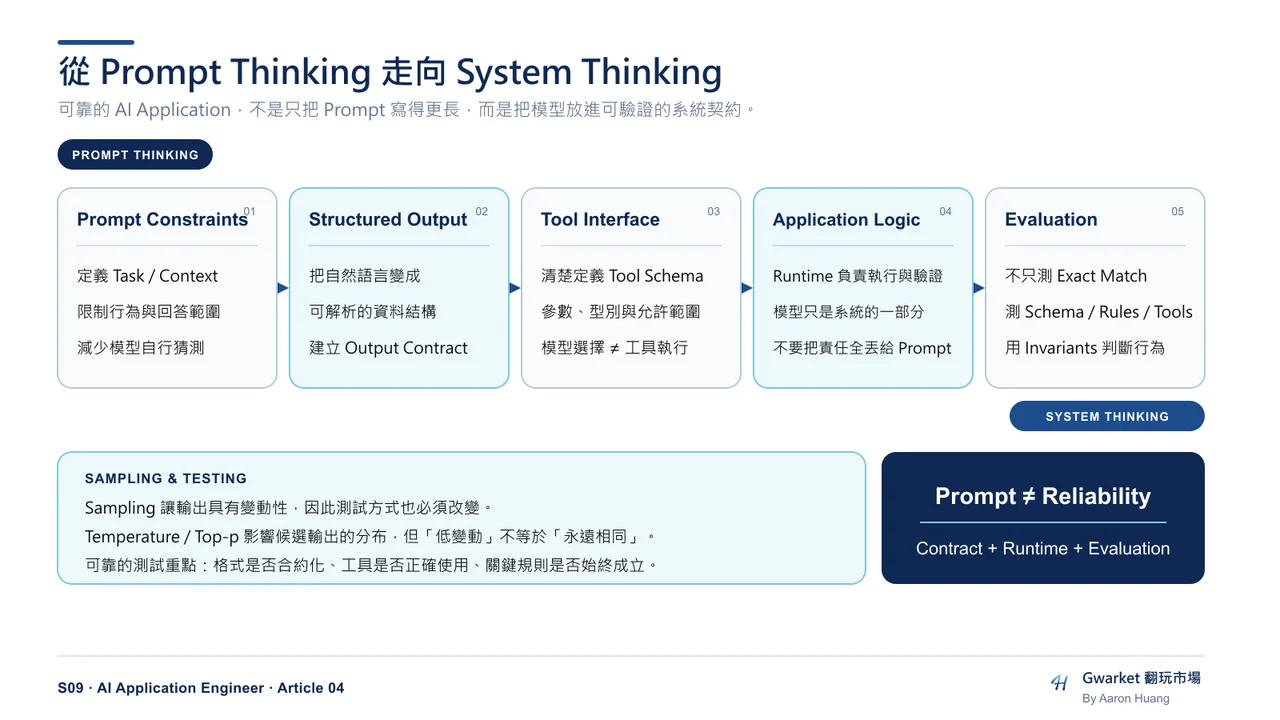
十三、所以 Prompt Engineering 其實只是其中一層
把整篇文章串起來,就會發現:
一個可靠的 LLM Application 不會把所有希望都壓在 Prompt 上。
比較完整的結構反而是:
Prompt
↓
Constraints
↓
Structured Output
↓
Schema Validation
↓
Tool Interface
↓
Application Logic
↓
Evaluation
Prompt 負責告訴模型:
你應該怎麼做。
Structured Output 負責定義:
你的回答必須長什麼樣子。
Tool Calling 負責:
你可以向外部世界取得什麼能力。
Sampling 告訴我們:
為什麼模型結果天然可能變動。
Testing 則回答:
在輸出可能變動的情況下,我們怎麼判斷系統仍然正常。
十四、真正的轉變:從 Prompt Thinking 走向 System Thinking
這也是 AI Application Engineer 很重要的一個能力分界。
初學者遇到模型答錯,第一個反應通常是:
Prompt 再改一下。
這有時候有效。
但真正進入 Production 之後,更應該問:
這是 Prompt 問題?
還是 Context 不夠?

是輸出格式不穩?
還是 Schema 沒有限制?

是模型沒有資料?
還是應該呼叫 Tool?

是模型正常的 Sampling Variation?
還是真的 Regression?

是模型回答不好?
還是整個 System Design 有問題?
這時我們已經不再只是在「使用一個模型」。
而是在設計:
一個包含機率模型的軟體系統。
而這也會帶出下一個更大的問題。
即使 Prompt 寫得很好、Structured Output 正確、Tool Calling 成功,每個單點看起來都正常:
整個 AI 系統真的就可靠了嗎?
答案通常沒有這麼簡單。
因為真正上線之後,我們還要面對:
- model failure
- retrieval failure
- tool failure
- validation
- fallback
- observability
- cost
- latency
- evaluation
這些問題已經不只是 Prompt Engineering。
而是 Production AI Engineering。
這就是下一篇要處理的問題。