Context 越長越好嗎?從 Token、Context Window 到 Context Engineering
如果上一篇〈LLM 不是知識庫〉建立的是第一個心智模型——LLM 會根據目前可見的條件逐步生成內容——那下一個問題就是:
模型現在到底看得到什麼?
很多 AI 應用的問題,最後都不是「模型不夠強」,而是模型根本沒有在當下看到正確資訊。
你可以換更大的模型、把 Prompt 寫得更長、一次塞更多文件,但只要真正需要的規則沒有進入 context、舊資料和新資料互相衝突,或重要訊息被大量無關內容淹沒,結果仍然可能很差。
所以這篇要處理三個容易混在一起的概念:
- Token:模型處理文字時的基本單位。
- Context Window:一次推論可以使用的 token 空間。
- Context Engineering:決定這次推論到底應該讓模型看到什麼。
核心不是「怎麼塞更多資料」,而是:
如何讓有限的 context 裡,留下最有用的資訊。
1. Token 不是字數,也不是單字數
LLM 不會直接把整段文字當成我們看到的「字」或「單字」來處理。
文字會先經過 tokenizer,被轉成一串 token IDs,再交給模型處理。
概念上可以理解成:
Text
  ↓
Tokenizer
  ↓
Token IDs
  ↓
Model
Token 可能是一個完整單字、單字的一部分、標點、空白,或其他文字片段。不同 tokenizer 的切法也不完全一樣。
例如英文中的一個少見單字,可能被拆成數個 subword;同一段內容換成不同模型,也可能產生不同 token 數。
因此:
Token 數量 ≠ 字數
Token 數量 ≠ 英文單字數
Hugging Face 目前的 Transformers 文件仍將 BPE、Unigram、WordPiece 等列為常見的 subword tokenization 方法;它們的共同目的,是用有限詞彙表表示大量文字,而不是要求每個單字都成為一個獨立 token。
為什麼應用工程師要在意 Token?
因為 Token 不只是模型內部名詞,它會直接碰到工程限制:
- 一次能送多少內容進模型。
- 最多能生成多少內容。
- API 成本如何計算。
- 對話歷史能保留多少。
- 文件是否需要切分。
- 工具結果是否應該壓縮。
- 長任務什麼時候需要摘要或外部記憶。
所以 Token 可以先把它理解成:
LLM 系統裡的容量單位之一。
2. Context Window 是一次推論的工作空間
假設模型這次要回答:
「這位客戶符合最新退款政策嗎?」
真正影響模型判斷的,不只有這一句使用者問題。
一次推論裡,應用可能同時提供:
System / developer instructions
Conversation history
User question
Retrieved documents
Tool results
Examples
Output constraints
這些內容一起形成模型當下可見的 context。
不同供應商與模型對 context window 的計算方式會有差異。以 OpenAI 目前的 API 文件為例,context window 被描述為單次請求可使用的最大 token 數,會涉及輸入、輸出,以及部分模型的 reasoning tokens。因此實作時不能拿某個模型的規格直接套到所有模型。
但跨供應商可以保留一個比較穩定的理解:
Context Window 是模型這一次工作時可使用的有限資訊空間。
這和「模型永久記住多少東西」不是同一件事。
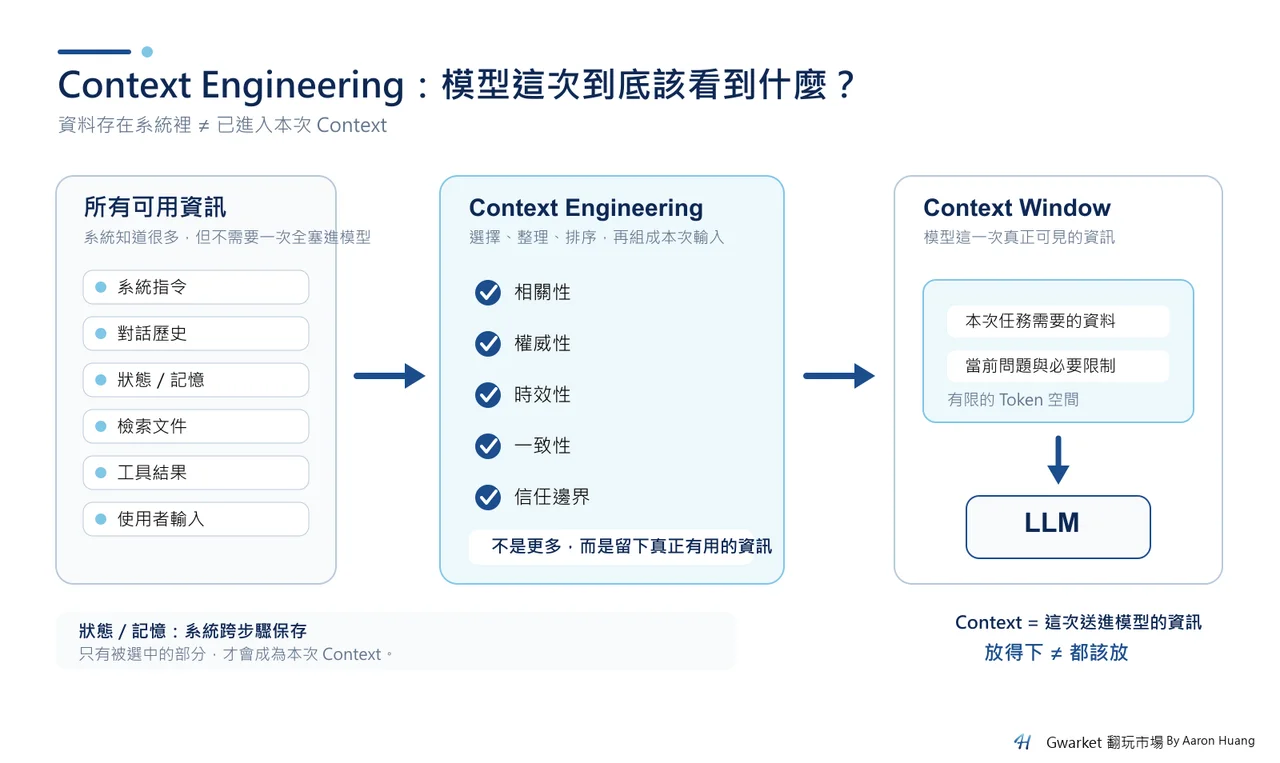
3. Context、State、Memory 不要混在一起
這是做 AI Application 很容易混亂的地方。
可以先用下面這個簡化模型區分:
State / Memory
= 應用在模型外部保存的資訊

Context
= 這一次真正送進模型的資訊
例如一個客服系統可能保存:
- 客戶過去 3 年的訂單。
- 20 次客服紀錄。
- 公司全部政策。
- 使用者偏好。
- 目前工單狀態。
這些都可能存在系統裡,但模型每一次推論並不需要全部看到。
應用可能只選出:
最新退款政策
+
最近一筆訂單
+
目前這張工單
+
使用者現在的問題
然後組成這一次的 context。
因此:
有資料,不代表資料已經進入 Context。
反過來,模型「記得上一輪」也不必然代表它具有永久記憶。很多對話系統只是把先前訊息重新放進下一次請求。
這也是為什麼 Context Engineering 和 Memory Engineering 是不同問題。
Memory 解決:
哪些資訊要跨時間留下來?
Context Engineering 解決:
現在這一步,哪些資訊值得拿出來給模型看?
4. Context Window 變大,不代表答案一定變好
這裡最容易出現一個直覺:
如果模型可以吃更多 token,那就把資料全部放進去最安全。
問題是,容量增加和資訊使用效率不是同一件事。
2023 年的《Lost in the Middle》研究測試了多文件問答與 key-value retrieval,發現受測模型對資訊位置具有敏感性:相關資訊放在輸入開頭或結尾時常有較好表現,而在中間位置時可能下降。
這項研究不能直接解讀成:
「現在所有模型一定看不到 context 中間。」
模型架構、訓練方式與長 context 能力都持續在改進。
它真正提醒我們的是:
支援某個 Context Window 長度,只代表模型可以接受這麼多內容,不等於每一段資訊都能被同樣穩定地利用。
Anthropic 在 2025 年的 Context Engineering 工程文章也把 context 描述為有限資源,並建議追求較小、較高訊號的資訊集合,而不是無限制累積內容。
所以「長 Context」至少有四種實際代價:
1. 無關資訊增加
模型需要從更多資料中找出真正重要的訊號。
2. 衝突增加
新版政策、舊版政策、不同來源的說法可能同時存在。
3. 成本與延遲增加
實際影響依模型與 API 而異,但更多 token 通常意味著更多處理量。
4. Debug 更困難
當輸出錯誤時,你更難判斷到底是:
- 資料沒有進 context。
- 正確資料被錯誤資料干擾。
- 指令互相衝突。
- retrieval 找錯內容。
- 模型沒有正確使用已提供的資訊。
所以 Context Window 解決的是:
能不能放得下。
但 AI Application 真正需要解決的是:
到底該放什麼。
5. 一個具體例子:退款政策為什麼不是塞越多越好
假設客服 AI 的 context 裡面有:
A. 2026 最新退款政策
B. 產品型錄 20 頁
C. 2024 舊版退款政策
D. 客戶目前訂單
E. 使用者問題
所有資訊都「放進去了」。
但系統仍然可能有問題:
- 新舊政策互相衝突。
- 產品型錄和問題無關。
- 最新政策沒有清楚標示版本。
- 模型可能引用舊規則。
- 回答沒有指出判斷依據。
更好的做法不一定是換一個更長的 Context Window。
而可能是:
先確認任務
   ↓
找出必要資料
   ↓
只取最新有效政策
   ↓
取回目前訂單
   ↓
標示資料版本與來源
   ↓
組成 Context
   ↓
讓模型判斷 / 說明
這已經不是單純的 Prompt Writing。
這就是 Context Engineering。
6. Context Quality 比 Context Quantity 更重要
如果要快速檢查一段 context,我會先看五件事。
Relevance:相關性
這些資訊真的和現在的任務有關嗎?
Authority:權威性
規則、數字與事實來自哪裡?是不是應該信任的來源?
Freshness:時效性
資料是不是最新版本?有沒有已經失效的內容?
Consistency:一致性
不同資訊有沒有互相衝突?衝突時誰優先?
Structure:結構
模型能不能分清楚:
- 哪些是系統指令。
- 哪些是公司資料。
- 哪些是使用者輸入。
- 哪些是外部未信任內容。
- 哪些只是工具結果。
可以簡化成:
Good Context
=
Relevant
+ Trusted
+ Current
+ Consistent
+ Well-structured
這不是正式公式,而是一個工程檢查框架。
7. Prompt Engineering 和 Context Engineering 差在哪?
Prompt Engineering 沒有消失。
但 Prompt 只是 Context 的一部分。
| Prompt Engineering | Context Engineering | |
|---|---|---|
| 核心問題 | 指令怎麼寫? | 模型這次到底應該看到什麼? |
| 常見內容 | 任務、角色、限制、格式、範例 | Prompt、歷史訊息、RAG、Memory、工具結果、權限資訊 |
| 常見失敗 | 指令模糊 | 過時、衝突、污染、過長、缺資料 |
| 工程重點 | 表達任務 | 管理整個推論環境 |
Anthropic 對 Context Engineering 的定義也接近這個方向:不是只設計 Prompt,而是策展與維護推論時最適合的一組 token,包括 system instructions、tools、external data、message history 等。
所以可以把兩者的關係理解成:
Prompt Engineering
        ⊂
Context Engineering
也就是 Prompt Engineering 是其中一部分,而不是全部。
8. Context Engineering 可以怎麼做?
實務上不需要一開始就做複雜框架。
可以先走五步。
Step 1:定義這一步模型要完成什麼
分類、摘要、回答、抽取、規劃、決策支援,需要的 context 都不一樣。
Step 2:列出必要資訊
沒有這些資訊,模型就無法合理完成任務的是什麼?
Step 3:過濾
移除:
- 無關資料。
- 重複資料。
- 過時版本。
- 不必要的完整工具輸出。
Step 4:標示來源與信任層級
至少要知道哪些內容是:
Trusted instruction
Trusted business data
User-provided content
External / untrusted content
Step 5:用 Evaluation 驗證
不要只看一兩次回答覺得「好像不錯」。
應該比較:
- 有沒有漏掉必要資訊。
- 是否使用正確版本。
- 不同 retrieval 結果會不會影響答案。
- context 縮短後品質是否真的下降。
- 是否存在不必要的 token 與成本。
Context Engineering 最終仍然要回到 Evaluation,而不是靠感覺調 Prompt。
9. 更長時間的任務,不能只靠一個 Context Window
如果任務從一次問答變成:
- 長時間研究。
- 大型程式碼修改。
- 多輪 Agent 執行。
- 跨多個 session 的工作。
問題就會更明顯。
資訊會不斷累積,但模型不可能永遠把所有原始歷史完整保留在同一個 context。
因此現在常見的做法包括:
- Retrieval:需要時再取資料。
- Compaction:把歷史內容壓縮成較短摘要。
- Structured notes:把重要狀態存在模型外部。
- Memory:保存可跨任務使用的資訊。
- Tools:讓模型需要時自己讀取檔案或資料,而不是預先全部塞入。
- Subagents:讓不同工作在較乾淨的 context 中處理,再回傳濃縮結果。
這裡的共同原理仍然沒有改:
不要要求模型永遠記住一切,而是設計它在每一步能取得真正需要的資訊。
10. 結論:Context Window 是容量問題,Context Engineering 是選擇問題
學 Context Window,如果最後只記得「某模型有多少 K Token」,價值其實很低。
模型規格會持續更新。
更重要的是留下這個 Mental Model:
System knows a lot
        ↓
Context Engineering selects
        ↓
Model sees a subset
        ↓
Model makes this inference
AI Application Engineer 真正要控制的,不只是模型。
還要控制:
什麼資訊,在什麼時間,以什麼形式進入模型。
Context Window 決定的是容量上限。
Context Engineering 決定的是這些容量被拿來裝什麼。
而這也會自然帶到下一個問題:
模型拿到這些 token 之後,到底怎麼建立它們之間的關係?Attention 和 Embedding 又分別在做什麼?
下一篇,我們再往模型內部走一層。
來源與驗證範圍
本篇由 Hello-Agents 第三章學習母資料延伸,並於 2026-09-21 重新核對以下來源。本文不把特定供應商的 context window 規格當成跨模型通則,也不主張長 context 一定會造成固定幅度的品質下降。
- Datawhale / Hello-Agents — 第三章〈大語言模型基礎〉:Tokenization、Token 與 Context Window 的教材脈絡。 https://github.com/datawhalechina/hello-agents/blob/main/docs/chapter3/%E7%AC%AC%E4%B8%89%E7%AB%A0%20%E5%A4%A7%E8%AF%AD%E8%A8%80%E6%A8%A1%E5%9E%8B%E5%9F%BA%E7%A1%80.md
- Hugging Face Transformers — Tokenization algorithms:BPE、Unigram、WordPiece 與 subword tokenization。 https://huggingface.co/docs/transformers/tokenizer_summary
- OpenAI API — Conversation state / Managing the context window:context window 與 input、output、reasoning token 的產品實作說明。 https://developers.openai.com/api/docs/guides/conversation-state
- Anthropic Engineering — Effective context engineering for AI agents:context engineering、有限 context 資源、just-in-time retrieval、compaction 與 structured note-taking。 https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts:長 context 中資訊位置與使用表現的研究。 https://arxiv.org/abs/2307.03172