模型沒壞,系統也可能失敗:Production AI 到底在可靠什麼?
上一篇談到 Prompt、Structured Output、Tool Calling 與 nondeterministic testing。
我們最後得到一個很重要的轉變:
AI Application 不是一段 Prompt,而是一個包含機率模型的軟體系統。
但這會立刻帶出下一個問題。
假設:
- Prompt 寫得很清楚
- Structured Output 格式正確
- Tool Calling 也成功
- 單次測試看起來沒有問題
這樣是不是就可以上線了?
不一定。
因為真實 Production 環境裡,最常發生的事情不是「模型完全壞掉」。
而是:
每一層都只壞一點點,最後整個系統變得不可靠。
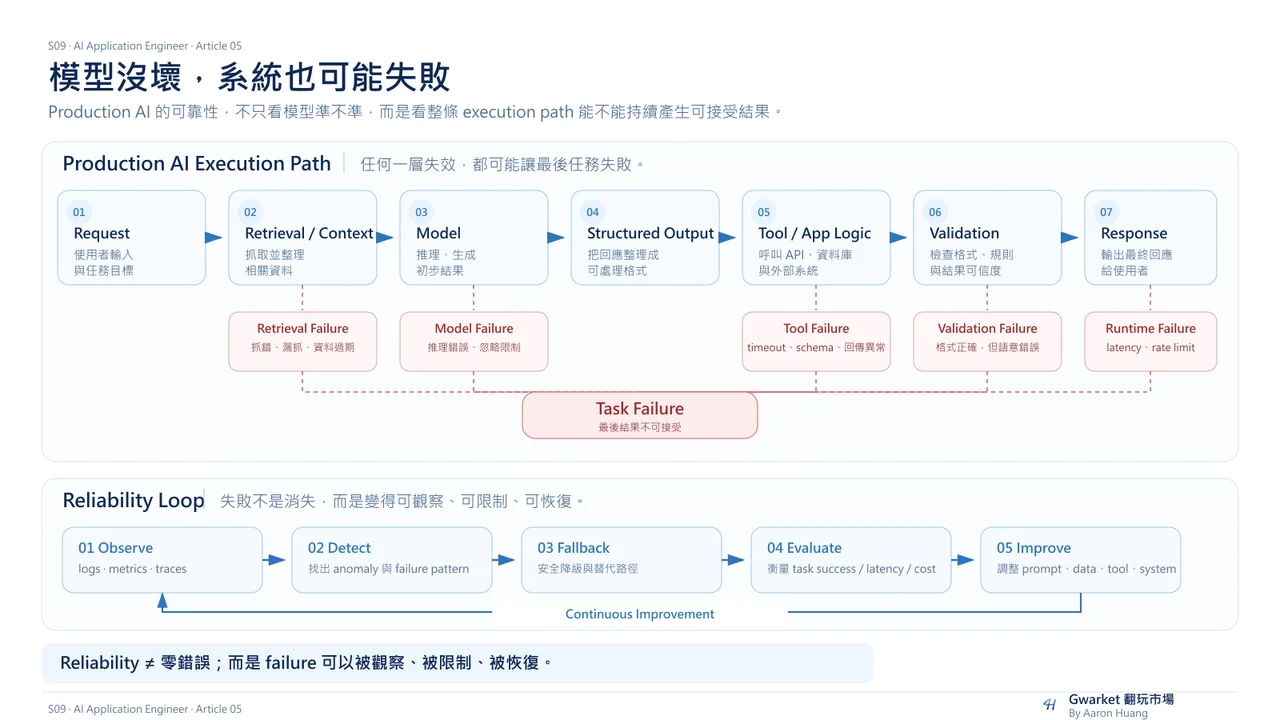
一、Production AI 的問題,不只是 Model Quality
很多 AI Demo 的核心問題是:
模型回答得好不好?
Production AI 的問題則更接近:
整個系統能不能持續產生可接受的結果?
這兩個問題差很多。
假設一個客服 AI:
User
↓
Retrieve customer data
↓
LLM
↓
Tool call
↓
Order system
↓
Validation
↓
Final response
其中任何一層都可能出問題:
Retrieval 抓錯資料
Tool timeout
API schema 改變
模型忽略限制
Validation 沒擋住
Fallback 沒有啟動
甚至模型本身完全正常。
最後結果還是錯的。
所以 Production AI 的 Reliability,不能只用:
Model Accuracy
來理解。
更接近:
System Reliability
=
Model
× Data
× Retrieval
× Tools
× Validation
× Runtime
× Monitoring
這不是正式數學公式。
它只是提醒我們:
只要其中一層很弱,整體就可能失敗。
二、先理解一件事:AI Failure 很少只有一種
傳統程式的錯誤常常比較明確。
例如:
HTTP 500
Database connection failed
NullPointerException
AI 系統的錯誤卻常常沒有那麼乾脆。
它可能:
- 正常回傳 HTTP 200
- JSON 格式正確
- latency 正常
- 沒有 exception
但答案就是錯的。
這代表 AI Application 至少要同時處理兩種 failure。
Hard Failure
系統明確壞掉。
例如:
API timeout
Tool unavailable
JSON parse error
Rate limit
Authentication failure
這類問題通常比較容易偵測。
因為系統會留下明確訊號。
Soft Failure
系統「看起來正常」,但結果不好。
例如:
模型誤解問題
Retrieval 抓到不相關文件
Tool 用錯參數
模型忽略關鍵 Context
輸出格式正確但內容判斷錯誤
這類 failure 更麻煩。
因為:
程式沒有壞,但產品壞了。
這也是 Production AI 和一般 Backend Engineering 很不同的地方。
三、Model Failure:模型不是固定函式
我們先從最直觀的一層開始。
即使:
Prompt 一樣
Model 一樣
Input 類似
模型表現仍可能不同。
原因可能包括:
- Input distribution 改變
- Context 太長
- Instructions 互相衝突
- Sampling variation
- 模型對邊界案例理解不足
- provider model version 改變
- upstream 資料品質下降
所以 Production 系統不能假設:
昨天測試通過
=
今天永遠正常
這是一個很重要的觀念:
LLM quality 不是一次性的 property,而是需要持續觀察的 behavior。
四、Retrieval Failure:RAG 不是「有接資料庫就會比較準」
如果系統用了 RAG,很多人會直覺認為:
有外部知識,所以 hallucination 就解決了。
但 Retrieval 本身也可能失敗。
例如:
User query
↓
Embedding
↓
Vector Search
↓
Retrieved Documents
↓
LLM
這條鏈裡至少有幾個問題。
沒抓到正確文件
真正答案存在,但 retrieval 沒找到。
抓到不相關文件
文件很像,但其實回答不了問題。
文件太多
大量 Context 反而稀釋重要資訊。
文件過期
資料曾經正確,但現在已經不是最新版本。
Ranking 錯誤
真正重要的文件被排在後面。
所以 RAG 系統真正要問的不是:
有沒有 Retrieval?
而是:
Retriever 是否真的把完成這個任務需要的資訊送進 Context?
這和前面談過的 Context Engineering 直接連起來。
五、Tool Failure:模型選對 Tool,不代表任務成功
上一篇提到:
LLM 通常負責決定:
Which tool?
Which arguments?
Application Runtime 才負責真正執行。
但這代表 Tool layer 本身會引入新的 failure modes。
例如模型正確呼叫:
get_order_status(order_id="A123")
但 API 回:
503 Service Unavailable
這不是模型的錯。
還有另一種:
HTTP 200
但 response:
{
  "status": null
}
這時候工具 technically 成功。
但 information quality 失敗。
再比如:
Tool schema 改版
Field name 改變
Rate limit
Timeout
Partial response
Permission denied
所以真正的 Tool Reliability 不能只檢查:
Did the API return?
而要問:
Did it return usable information?
六、Validation:模型的輸出不能直接被相信
假設模型輸出:
{
  "refund_amount": 9000
}
格式完全正確。
Schema 也正確。
但如果這筆訂單只有:
NT$900
那還是不能執行。
因此 Production AI 通常需要不同層級的 Validation。
1. Syntax Validation
是不是合法格式?
例如 JSON 能不能 parse。
2. Schema Validation
欄位、型別、enum 是否正確?
例如:
priority ∈ {low, medium, high}
3. Business Rule Validation
即使格式正確,是否符合業務規則?
例如:
refund_amount <= order_amount
4. Semantic Validation
答案是否真的符合 Context?
例如:
模型說客戶已付款
但來源文件其實沒有付款紀錄。
這類 validation 比較難。
有時候需要:
- rule-based check
- secondary model
- retrieval evidence
- human review
- deterministic computation
重點不是每個系統都要把四層全部做滿。
而是:
不要把「模型有輸出」當成「結果可以使用」。
七、Fallback:Failure 不一定要變成 System Failure
真正成熟的系統,不是完全不失敗。
而是知道:
失敗時要怎麼退。
例如 AI 無法完成任務:
Primary model
↓ fail
Fallback model
這是一種 fallback。
但 fallback 不一定是換模型。
也可以是:
AI answer unavailable
↓
return deterministic search results
或:
Tool unavailable
↓
ask user to retry later
甚至:
Confidence / validation failed
↓
do not generate final answer
Production Reliability 很重要的一個思維是:
Graceful Degradation
系統能力可以下降。
但不一定要直接亂掉。
八、Retry 不是萬用解法
遇到 timeout 時,很多工程師第一個想到的是:
Retry
有時候確實有效。
例如短暫 network failure。
但如果原因是:
Prompt 本身有問題
Tool schema 錯誤
文件就是不存在
模型持續做出同樣錯誤判斷
Retry 只是在:
重複失敗。
甚至還會增加:
- latency
- cost
- rate limit pressure
所以比較好的判斷是:
Is this failure retryable?
而不是:
Did it fail?
→ Retry everything
九、Observability:沒有 Trace,你根本不知道是哪一層壞掉
假設使用者說:
AI 今天回答品質變差了。
這句話對工程師幾乎沒有用。
因為問題可能出在:
Prompt
Context
Retrieval
Model
Tool
Validation
Runtime
如果系統最後只記錄:
User input
Final answer
你很難知道中間發生了什麼。
所以 Production AI 很重要的一層是:
Observability
至少要能回答:
這次用了哪個 model?
Prompt / system instruction 是哪個版本?
Context 有哪些資料?
Retriever 抓了哪些 documents?
呼叫了哪些 tools?
Tool latency 多少?
Tool 回了什麼狀態?
Validation 有沒有失敗?
Token 使用多少?
整體 latency 多少?
這就是為什麼很多 AI 系統會保留:
Trace
把一次 request 看成一條 execution path。
十、Log、Metric、Trace 是不同的東西
這裡可以稍微拆一下。
Log
記錄某個事件。
例如:
tool_call_failed
Metric
把事件變成可觀察的數字。
例如:
tool_failure_rate = 2.8%
Trace
把一次完整 request 的流程串起來。
例如:
Request #8291

Retrieval  120ms
↓
LLM       1.8s
↓
Tool      420ms
↓
LLM       1.1s
↓
Validation PASS
三者目的不同。
在 AI 系統裡,Trace 特別重要。
因為一次結果往往是多個 component 共同產生的。
十一、Latency:AI UX 很容易被多步驟拖垮
假設:
LLM call = 2 sec
看起來不慢。
但系統實際流程是:
Retrieval          0.3s
LLM                2.0s
Tool               0.8s
LLM                1.7s
Validation Model   1.5s
總 latency 已經:
6.3s
如果再 retry:
10s+
很容易發生。
所以 Production AI 需要看的不是:
單次 model latency
而是:
End-to-End Latency
因為使用者感受到的是整個 request 花多久。
不是某一個 API 花多久。
十二、Cost:每一步多一個 Model Call,都有代價
AI 系統很容易出現這種設計:
Main LLM
↓
Critic LLM
↓
Rewrite LLM
↓
Validation LLM
品質可能提升。
但 cost 也可能快速增加。
再加上:
long context
retrieval
tool usage
retry
一個 request 的實際成本可能比表面看到的高很多。
所以 Production AI 的問題從來不只是:
哪個模型最好?
而是:
這個品質提升
值不值得增加
成本 + latency + complexity?
這其實是一個工程 trade-off。
十三、Evaluation:不是上線前考一次試
AI Evaluation 很容易被理解成:
上線前跑一組 benchmark。
但 Production 環境真正需要的是兩個階段。
Offline Evaluation
在固定 dataset 上測。
例如:
100 個客服案例
每次:
- 換 Prompt
- 換 Model
- 改 Retrieval
- 改 Tool schema
之後重新測。
這很適合做 regression detection。
Online Evaluation
系統上線後觀察真實流量。
例如:
task success rate
tool failure rate
fallback rate
human escalation rate
user correction rate
latency
cost
Offline Evaluation 回答:
改動前後,在我們知道的案例上有沒有變差?
Online Evaluation 則回答:
真實世界現在到底發生什麼?
兩個不能互相取代。
十四、不要只量「Answer Quality」
如果只追蹤:
Answer Quality Score
常常不夠。
因為 Production 系統還有很多真正影響產品的指標。
例如:
Task Success Rate
Schema Valid Rate
Tool Success Rate
Retrieval Hit Rate
Fallback Rate
Latency P95
Cost per Request
具體指標要看產品。
客服 AI 和 Coding Agent 不會用同一組 metric。
所以不要先問:
AI Application 有哪些標準 KPI?
而應該先問:
這個系統真正必須成功完成什麼?
再往回設計 measurement。
十五、Reliability 不是「零錯誤」
這一點很重要。
Production System 不可能要求:
100% never fail
傳統軟體做不到。
AI 系統更做不到。
所以 Reliability Engineering 真正做的是:
知道哪些地方會失敗
↓
可以偵測
↓
可以限制影響
↓
可以恢復
↓
可以持續改善
因此可靠系統不是:
從來不失敗。
而是:
失敗是可觀察、可控制、可恢復的。
十六、從「模型準確率」轉成「系統成功率」
整篇文章最重要的轉變,可以濃縮成這張圖:
Model Thinking

這個模型準不準?
        ↓

System Thinking

這個任務最後有沒有成功?
        ↓
如果失敗,是哪一層?
        ↓
系統能不能發現?
        ↓
系統能不能安全退回?
        ↓
下一次能不能知道有沒有改善?
這也是 Production AI Engineer 和單純 Model User 很大的差別。
十七、一個比較完整的 Production AI Loop
可以把前面所有概念串成:
Request
↓
Context / Retrieval
↓
Model
↓
Structured Output
↓
Tool / Application Logic
↓
Validation
↓
Response
↓
Observability
↓
Evaluation
↓
Improve
這時候你會發現:
LLM 其實只是整個系統中間的一個 component。
模型很重要。
但 Production AI 的品質,不只取決於模型。
而是取決於:
整條 execution path 是否被設計、驗證、觀察與控制。
十八、這和 Agent 有什麼關係?
到目前為止,這篇其實完全不需要 Agent。
一個普通的:
RAG + LLM + Tool
Application 就已經會面對:
- failure
- validation
- fallback
- observability
- latency
- cost
- evaluation
這一點很重要。
因為很多問題不是:
Agent 才需要考慮。
而是:
只要 AI 進入 Production,就必須考慮。
Agent 只會把問題再放大。
因為當模型開始:
觀察
↓
決策
↓
行動
↓
再觀察
系統就不再只是一次 Input → Output。
而會開始形成:
閉環。
這也是下一篇要真正進入的問題:
AI Agent 到底是什麼?
不是「有 LLM + Tool 就叫 Agent」。
真正的 Agent,關鍵在於它是不是形成了一個可以根據環境結果持續決策的閉環系統。