Action Space、Permissions、HITL、Stop Conditions:怎麼讓 Agent 有能力但不失控
上一篇我們把 Agent 拆成:
State
+
Tools
+
Memory
+
Runtime
也看到了真正維持 Agent 運作的,不只是 LLM,而是模型外面的 application system。
到這裡,一個 Agent 已經可以:
讀資料
↓
做 Decision
↓
呼叫 Tool
↓
改變 Environment
↓
讀取 Result
↓
繼續下一輪
但也正是在這一刻,問題開始改變。
前面我們在問:
Agent 能不能完成任務?
現在必須開始問:
Agent 到底被允許做什麼?
因為一旦模型不只是生成文字,而是可以:
send_email()
write_file()
delete_record()
update_ticket()
create_booking()
deploy_service()
錯誤就不再只是:
答錯一句話。
它可能變成:
真的做錯一件事情。
這就是 Agent system 從「Capability」走向「Governance」的分界。
一、Agent 的風險不是因為它會犯錯,而是錯誤可以變成 Action
一般 Chatbot 回答錯誤時:
Wrong Answer
通常還停留在資訊層。
但 Agent 的流程可能是:
Wrong Decision
↓
Wrong Tool
↓
Wrong Action
↓
Environment Changed
例如:
模型誤判:
這是一封垃圾郵件

↓

Tool:
delete_email()

↓

Email 真的消失
或:
模型誤判:
這個 deployment 可以執行

↓

Tool:
deploy_production()

↓

Production 被改變
這就是為什麼 Agent architecture 不能只討論:
Reasoning Quality
還必須討論:
Action Control
二、第一個問題:Agent 到底有哪些 Action 可以選?
在 Article 06,我們提過:
Action Space
現在可以更精確地定義:
Action Space 是 Agent 在某個 runtime 中被允許選擇的所有行動集合。
例如一個 Coding Agent:
read_file
search_code
write_file
run_tests
git_diff
如果再加入:
git_push
merge_pr
deploy_production
同一個模型的能力沒有變。
但它能造成的影響完全不同。
所以真正重要的不是:
模型有多聰明?
而是:
我們給了它多大的 Action Space?
三、最安全的 Action,不是 Agent 永遠不會犯錯,而是錯誤影響有限
可以想像兩種 Agent。
Agent A:
read_file
search_code
run_tests
Agent B:
read_file
write_file
delete_file
git_push
deploy_production
即使兩個 Agent:
使用同一個 LLM
同一個 Prompt
同一個 Reasoning
風險也完全不同。
因為:
Risk
不只來自:
Probability of Error
也來自:
Impact of Action
可以用一個概念上的方式理解:
Operational Risk
≈
Error Probability
×
Action Impact
這不是精確數學公式。
但它提醒我們:
不能只想辦法讓模型更少犯錯,也要讓單次錯誤的 blast radius 更小。
四、所以 Action Space 應該從最小權限開始
這和資安裡常見的:
Least Privilege
概念很接近。
不要一開始就給 Agent:
所有 Tool
所有資料
所有寫入權限
所有 Production Action
更合理的是:
完成這個 Task
真正需要哪些 Action?
例如一個 Research Agent:
可能只需要:
search
read
summarize
根本不需要:
send_email
delete_file
modify_database
如果不需要:
就不要提供。
五、Tool 存在,不代表 Agent 應該可以直接執行
假設系統裡存在:
issue_refund()
這不代表模型只要決定:
我要退款。
系統就直接:
execute()
更安全的 architecture 可以是:
LLM Decision
↓
Policy Check
↓
Permission Check
↓
Execution
所以:
Tool Available
跟:
Tool Executable Right Now
是兩件不同的事。
六、Permission 應該存在 Runtime,不應只寫在 Prompt 裡
一個很危險的設計是:
System Prompt:
Never delete production data.
然後 Agent 同時擁有:
delete_production_data()
這其實是在要求:
模型永遠記得不要按那個按鈕。
Prompt 可以提供行為指示。
但真正重要的 permission boundary 不應該只存在自然語言裡。
更合理的是:
LLM
↓
requests Action
↓
Runtime checks policy
↓
Allowed?
├─ Yes → Execute
└─ No  → Reject
也就是:
Permission 是 system control,不只是 model instruction。
七、Read 和 Write 的風險通常不一樣
很多 Tool 可以先粗略分成:
Read
和:
Write
Read:
search_document
read_file
query_database
get_calendar
主要影響是:
取得資訊。
Write:
send_email
update_database
delete_file
book_flight
deploy_service
會:
改變 environment。
因此實務上可以讓:
Read Action
有較大的自主性。
而:
Write Action
需要更多控制。
但 Read 也不是永遠低風險。
例如:
read_salary_database
read_customer_PII
read_secret_key
本身就可能涉及敏感權限。
所以真正要看的是:
Action
+
Resource
+
Scope
八、Permission 不只是「可以/不可以」
想像一個 Tool:
send_email()
權限可能不是:
allowed
/
blocked
而是:
可以寄給自己
可以寄給內部同事
外部收件者需要批准
超過 20 人禁止
附件含敏感資料禁止
所以 permission model 可能更像:
Who?
What?
Where?
How much?
Under what condition?
也就是:
Action Boundary。
九、這時候 Human-in-the-Loop 才真正有意義
HITL:
Human-in-the-Loop
常被理解成:
Agent 做完之後,人再檢查一次。
但更有價值的做法是:
把 Human 放在高風險 Decision Boundary。
例如:
Agent:
我要寄出 Email

↓

Runtime:
這是一個 external write action

↓

Human Approval Required

↓

Approve
↓
send_email()
這和:
整個任務做完才人工檢查
完全不同。
因為後者可能已經:
來不及了。
十、HITL 不應該放在每一步
如果每一個 Tool Call 都:
請人工確認
Agent 很快就失去價值。
例如:
read_file()
↓
Approve?

search()
↓
Approve?

run_test()
↓
Approve?
這會變成:
人類在幫 Agent 一直按 Continue。
所以 HITL 真正需要設計的是:
哪些 Action
值得打斷自動流程?
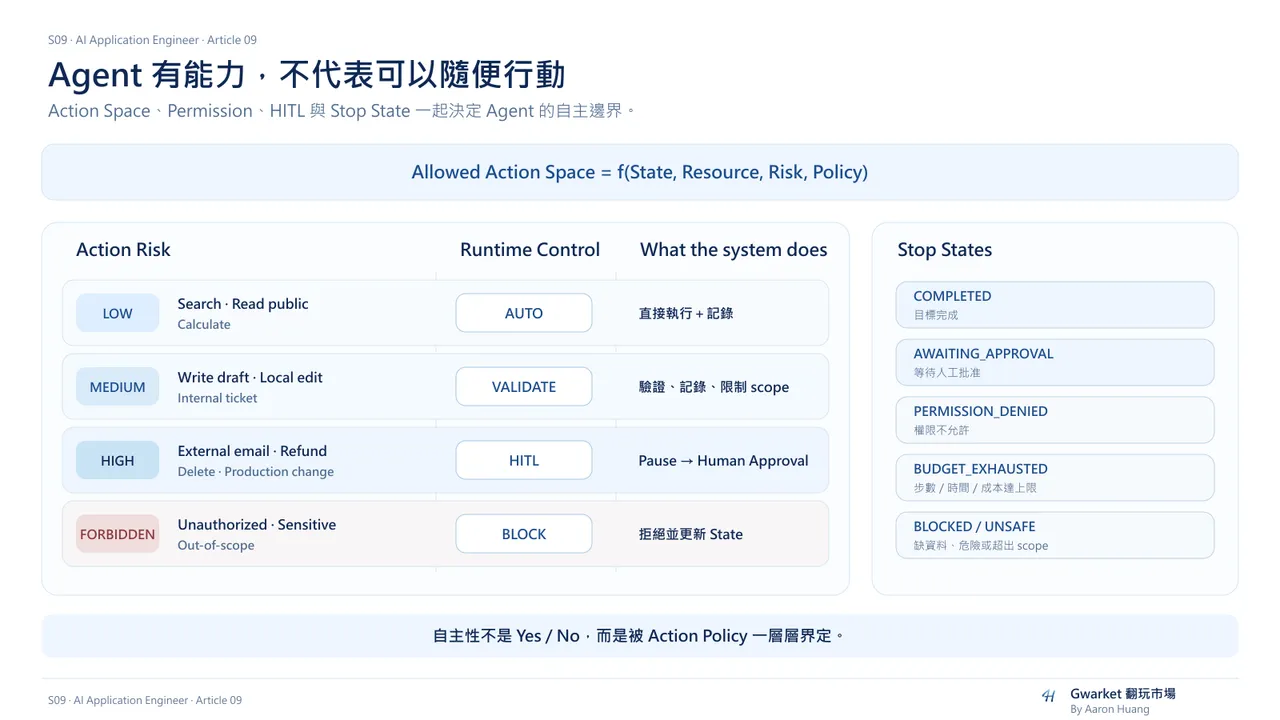
十一、一個實用做法:依 Action Risk 分級
可以把 Action 粗略分成:
| Risk Level | Action Example | Control |
|---|---|---|
| Low | search、read public docs、calculator | Auto |
| Medium | write draft、modify local file、create internal ticket | Auto + Logging / Validation |
| High | send external email、refund、delete、production change | Human Approval |
| Forbidden | 超出政策/敏感資料/未授權 production action | Block |
這不是一套所有公司都應該照抄的標準。
真正重點是:
不同 Action 不應該擁有相同的 execution policy。
十二、Draft → Approve → Execute 是非常好用的模式
對高風險 Action,可以把一次動作拆成:
Draft
↓
Review
↓
Execute
例如 Email:
Agent 產生 Email Draft
↓
Human Review
↓
Human Approve
↓
Runtime send_email()
退款:
Agent 建議退款 NT$2,000
↓
Policy Validation
↓
Human Approval
↓
Payment System Execute
Deployment:
Agent Prepare Changes
↓
Tests
↓
Preview / Diff
↓
Owner Approval
↓
Deploy
這個模式的優點是:
模型可以保留大量工作能力,但真正不可逆的 Action 被推遲到 approval boundary 之後。
十三、可逆性也是 Action Risk 的重要因素
兩個 Action:
create_draft()
以及:
send_email()
看起來都只是「寫入」。
但風險不同。
Draft:
容易修改
容易刪除
尚未對外生效
Send:
已經被別人收到
很難完全撤回
所以 Action Risk 不只看:
Read / Write
還可以看:
Reversible?
Externally Visible?
Financial Impact?
Production Impact?
Sensitive Data?
這些因素會決定:
是否需要 Approval。
十四、Permission 解決「可不可以做」,Stop Condition 解決「什麼時候不要再做」
前面一直談:
Action
但 Agent 還有另一個核心問題:
Loop
Article 06 的 Agent 是:
Observe
↓
Decide
↓
Act
↓
Observe
↓
...
如果沒有 Stop Condition:
它理論上可以:
一直跑
所以每個 Agent loop 都需要回答:
什麼情況下結束?
十五、最直覺的 Stop Condition:Goal Completed
例如 Coding Agent:
Goal:
Fix failing tests
Stop:
required tests passed
Research Agent:
Goal:
回答研究問題
Stop:
required claims have enough evidence
Booking Agent:
Goal:
完成預訂
Stop:
booking_status = confirmed
也就是:
Goal
↓
Success Condition
但只有 Success Condition 還不夠。
十六、Agent 也需要 Failure Stop
假設 Agent 一直:
Try
↓
Fail
↓
Retry
↓
Fail
↓
Retry
如果沒有 boundary:
可能永遠繼續。
所以需要例如:
max_attempts = 3
或:
same_failure_count >= 2
然後:
Stop
↓
Escalate
這是一種:
Failure Stop Condition。
十七、Budget 也是 Stop Condition
Agent 的 loop 會消耗:
Token
API Calls
Time
Compute
Money
所以有時候 Stop 不是因為:
已經成功。
而是:
繼續做的成本已經超過允許範圍。
例如:
max_steps = 20
max_tool_calls = 30
max_runtime = 10 minutes
max_cost = US$2
超過就:
Stop
或:
Ask Human
所以 Production Agent 不能只知道:
Goal
還要知道:
Budget
十八、沒有進展,也應該是一種 Stop Signal
Agent 有時不是一直失敗。
而是:
一直做不同事情
但沒有更接近 Goal
例如:
Search A
↓
Search B
↓
Search C
↓
Search D
↓
Search E
看起來一直有 Action。
但其實:
Progress = 0
這時候好的系統應該能判斷:
我是不是卡住了?
例如:
no_new_evidence
repeated_tool_pattern
same_state
no_score_improvement
都可能成為:
Stop / Replan / Escalate
的訊號。
十九、Stop 不一定代表「任務完成」
這點非常重要。
Agent 停止可能代表:
Completed
也可能代表:
Blocked
Need Human
Permission Denied
Budget Exhausted
Insufficient Information
Unsafe Action
Tool Failure
所以:
Stop
不是一個 boolean 就夠。
更好的設計是:
stop_reason
例如:
{
  "status": "stopped",
  "reason": "human_approval_required"
}
或:
{
  "status": "stopped",
  "reason": "max_attempts_exceeded"
}
這讓系統知道:
接下來應該怎麼處理。
二十、HITL 其實也是一種 Stop Condition
當 Agent 要執行:
High-Risk Action
Runtime 可以:
Pause
並產生:
Approval Request
也就是:
Agent Loop
↓
High-Risk Decision
↓
Pause
↓
Human Review
↓
Approve / Reject
↓
Continue / Stop
所以 HITL 並不是 Agent 外面的附加功能。
它其實可以是:
Agent State Machine 裡的一種正式狀態。
例如:
RUNNING
↓
AWAITING_APPROVAL
↓
RUNNING
或:
AWAITING_APPROVAL
↓
REJECTED
↓
STOPPED
二十一、Permission Denied 也不應該讓模型自己繞過去
假設 Agent 要:
delete_database()
Runtime 回:
permission denied
錯誤的設計是:
LLM:
那我換另一個 Tool 試試看怎麼刪。
這會讓 permission boundary 變成:
一個需要模型自己理解的提示。
更好的做法是:
Permission Denied
↓
State Update
↓
Action unavailable
甚至:
Stop / Escalate
也就是:
Policy decision 應該改變 Action Space 本身。
而不是只送一句:
不要這樣做喔。
二十二、Action Space 可以根據 State 動態縮放
Agent 不一定從頭到尾都有相同權限。
例如:
State = Research
可用:
search
read
summarize
到了:
State = Draft
增加:
write_draft
到了:
State = Approved
才開:
publish
這就形成:
State
↓
Allowed Action Space
也就是:
權限可以跟 workflow state 綁定。
二十三、這也解釋為什麼「讓 Agent 自主」不是 Yes / No
Autonomy 並不是:
Autonomous
/
Not Autonomous
更像是一組分開的控制:
可以自己搜尋?
可以自己讀資料?
可以自己改 local file?
可以自己送出 external message?
可以自己付款?
可以自己 deploy?
同一個 Agent 可以:
Research = highly autonomous
但:
Production Change = human approval required
所以比較實用的問題不是:
這個 Agent 有多自主?
而是:
它在哪些 Action Boundary 內自主?
二十四、真正好的 Agent Governance,是把 Agency 放在對的地方
假設一個任務:
研究市場
↓
整理方案
↓
寫 Proposal
↓
寄給客戶
可能設計成:
Research
→ Autonomous

Analysis
→ Autonomous

Draft
→ Autonomous

External Send
→ Human Approval
這樣:
Agent 還是做掉大部分工作。
但最重要的 irreversible boundary:
Send
仍然有人控制。
這通常比兩個極端都好:
全部人工
或:
全部自主
二十五、治理資訊也必須可觀察
如果 Agent 被阻擋:
我們應該知道:
哪個 Action?
哪條 Policy?
當時 State 是什麼?
模型提出什麼 Decision?
Human 是否批准?
最後執行什麼?
所以 Agent runtime 的 trace 不應只有:
LLM Prompt
LLM Response
還應該包含:
Action Requested
Permission Decision
Approval State
Execution Result
Stop Reason
這和 Article 05 的 Observability 接起來。
但差別是:
Article 05 在問:
Production AI 系統出了什麼問題?
Article 09 更聚焦:
Agent 的 agency 是怎麼被允許、阻擋、批准與停止的?
二十六、Agent 最重要的不是「永遠完成任務」
很多 Demo 會把成功定義成:
Agent finished the task
但 Production System 更成熟的成功可能是:
Agent correctly stopped
例如:
資訊不足
→ Stop and ask

需要權限
→ Stop and request approval

超出 scope
→ Stop

高風險 action
→ Pause

無法驗證
→ Escalate
有時候:
知道不能繼續,反而比繼續做更重要。
二十七、一個比較完整的 Governed Agent Loop
現在可以把 S09 前面的所有概念組起來。
Goal
↓
Load State
↓
Build Context
↓
LLM Decision
↓
Proposed Action
↓
Policy / Permission Check
↓
Allowed?
├─ No
│   ↓
│ Stop / Replan / Escalate
│
└─ Yes
    ↓
Risk requires Human Approval?
├─ Yes
│   ↓
│ Pause
│ ↓
│ Human Approve?
│ ├─ No → Stop
│ └─ Yes
│
└─ No
    ↓
Execute Tool
↓
Observe Result
↓
Update State
↓
Stop Condition?
├─ Yes → Stop with reason
└─ No  → Next Decision
這時候 Agent 才真正從:
可以做事
變成:
可以在受控邊界內做事。
二十八、S09 從 LLM 一路走到 Agent,其實是在增加「系統責任」
回頭看整個系列:
最開始我們理解:
LLM
不是知識庫。
接著理解:
Context
決定模型這次看得到什麼。
再理解:
Attention / Embedding
只是模型與語意表示的一部分。
接著:
Prompt
Structured Output
Tool Calling
Sampling
讓模型可以進入 application。
Production AI 再加入:
Validation
Fallback
Observability
Evaluation
Agent 再加入:
Goal
State
Tools
Memory
Dynamic Decision
而最後:
Permissions
HITL
Stop Conditions
其實是在回答:
當 AI 開始可以改變真實世界時,系統應該承擔什麼責任?
二十九、AI Application Engineer 真正設計的,不是 Prompt,而是 Boundary
做到最後會發現:
AI Application Engineer 的工作並不是:
讓模型盡可能自由
也不是:
把模型限制到什麼都不能做
真正要設計的是:
什麼讓模型判斷?
什麼寫成 deterministic rule?
什麼存在 State?
什麼進 Context?
什麼可以直接執行?
什麼需要 Approval?
什麼必須被 Block?
什麼時候必須 Stop?
這些:
Boundary Decisions
才是 AI Application architecture 的核心。
三十、S09 的最後一個結論
如果只看表面:
AI Agent 很像:
LLM
+
Tools
+
Loop
但真正進 Production 之後,更完整的樣子是:
Model
+
Context
+
State
+
Tools
+
Memory
+
Validation
+
Runtime
+
Permissions
+
Human Approval
+
Stop Conditions
+
Observability
+
Evaluation
而且:
不是 component 越多越好。
Article 07 已經給了整個系列最重要的約束:
Minimum Necessary Complexity
只有當 Task 真正需要:
才增加下一層能力。
最後我們真正想得到的,不是一個:
最自主的 Agent。
而是一個:
在明確邊界內,能可靠完成任務、知道何時行動,也知道何時停下來的 AI System。
這才是從:
LLM
走向:
AI Application Engineering
真正重要的轉變。