不用手算 Transformer:Attention、Embedding 到底在做什麼?
上一篇〈Context 越長越好嗎?〉處理的是一個應用層問題:
模型這一次到底應該看到什麼?
但資料進入 Context Window 之後,還有另一個問題:
模型怎麼處理這些 token 之間的關係?
這時就會遇到三個很容易混在一起的詞:
- Transformer
- Attention
- Embedding
很多教學會從矩陣、公式與模型架構開始講。這些內容對模型研究很重要,但如果你的目標是 AI Application Engineer,真正需要先建立的是另一套 Mental Model:
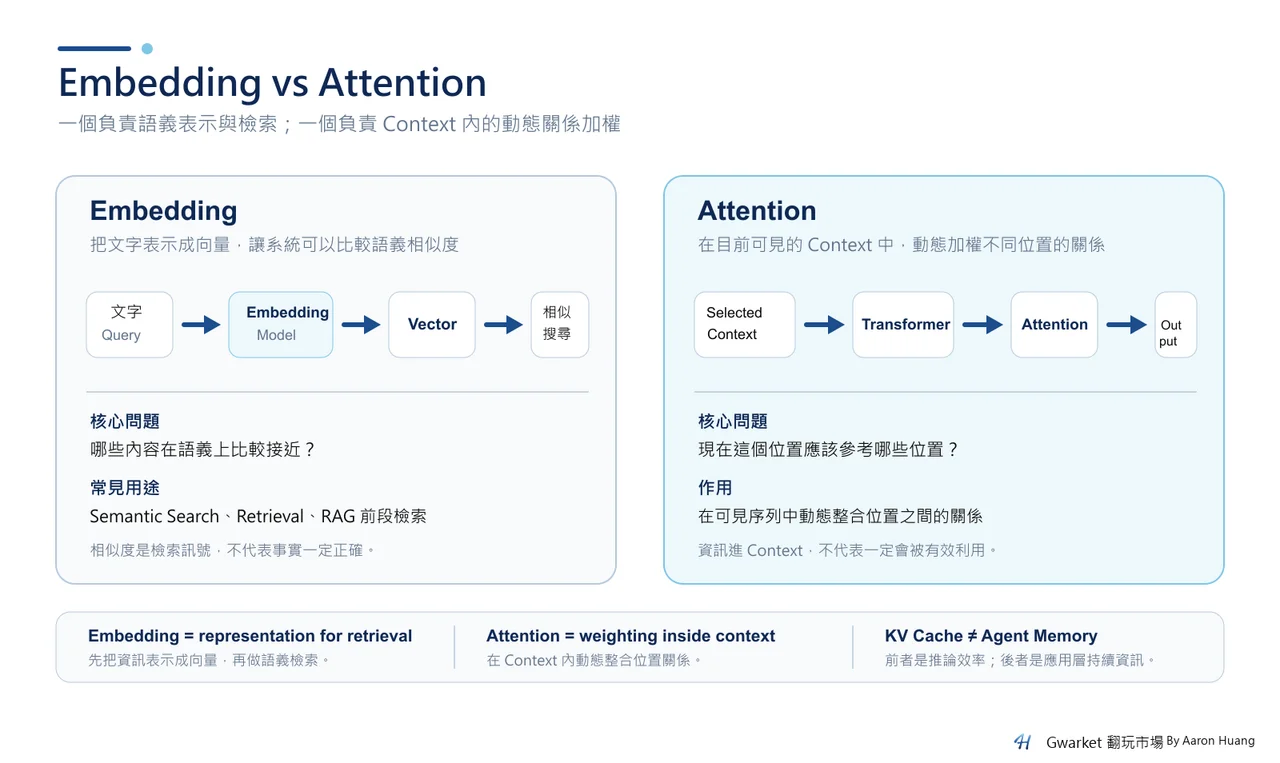
Attention 解釋模型如何在目前序列中動態參考其他位置;Embedding 解釋文字如何被表示成向量,讓語義相似度可以被計算。
理解這個差異之後,很多應用問題會突然變得比較具體:
- 為什麼 Context 很長會增加運算負擔?
- 為什麼把資料放進 Context,不代表模型一定會用對?
- 為什麼 Embedding 可以做 semantic search?
- 為什麼 Vector DB 不是 RAG 的全部?
- KV Cache 又到底在省什麼?
這篇不要求你手算 Attention。
我們只把原理理解到足以做工程判斷。
1. Transformer 解決的不是「讓 AI 會聊天」
2017 年的〈Attention Is All You Need〉提出 Transformer 時,研究背景主要是 sequence transduction,例如機器翻譯。
在 Transformer 之前,RNN 類序列模型通常依照順序處理資訊:
token 1
   ↓
token 2
   ↓
token 3
   ↓
token 4
前面的資訊要經過一連串 hidden state 傳到後面。
這種架構可以處理序列,但長距離資訊需要經過多步傳遞,訓練時也不容易把整個序列完全平行化。
Transformer 的重要改變,是讓序列中的位置能透過 Attention 更直接地建立關係。
簡化成:
token A ─┐
token B ─┼─→ 目前位置應該參考誰?
token C ─┤
token D ─┘
這讓不同位置之間可以更直接互相參考,也讓訓練更適合平行運算。
但這裡要留一個重要邊界:
2017 年原始 Transformer 是 encoder-decoder 架構,並不等於今天所有生成式 LLM 的完整設計。
現代模型已經加入很多後續改進。對應用工程師而言,真正值得留下的是:
Transformer 讓「目前這個位置,應該參考序列中的哪些資訊」成為核心計算之一。
2. Self-Attention:現在這個 token 應該看誰?
假設有一句話:
The bank approved the loan because it was financially stable.
當模型處理 it 時,不能只看前一個字。
它需要利用整個可見序列,判斷:
it跟bank的關係有多強?- 跟
loan呢? financially stable又提供什麼線索?
Self-Attention 可以先理解成:
對目前位置來說,序列中其他位置各值得參考多少?
這不是資料庫查詢,也不是「搜尋到唯一正確答案」。
它比較像是一個動態加權過程。
同一個 token 出現在不同句子裡,周圍資訊不同,Attention 關係也可能不同。
這就是為什麼上一篇談 Context Engineering 時,不能只問:
資料有沒有放進去?
還要問:
模型是否能在這個 Context 裡有效利用它?
3. Q、K、V 需要懂,但不用手算
Scaled Dot-Product Attention 常被寫成:
Attention(Q, K, V)
= softmax(QKᵀ / √dₖ)V
如果你不是要做模型研究,不需要現在拿紙筆算矩陣。
但 Q、K、V 的角色值得保留一個工程直覺:
Query
= 我現在需要找什麼線索?

Key
= 每個位置提供什麼可比對的線索?

Value
= 找到關聯之後,要帶回什麼資訊?
模型會利用 Query 與 Keys 計算 Attention 權重,再依權重組合 Values。
這個簡化模型已經足夠幫你理解幾件事:
- Attention 是動態的,會依目前輸入改變。
- 資訊進入 Context,不代表一定得到足夠權重。
- 無關與衝突內容可能影響模型如何使用其他資訊。
- Attention 不是 deterministic lookup,不能把它當資料庫索引。
所以:
Context Window 解決「能看到多少」,Attention 處理「目前應該參考哪些位置」。
兩者不是同一個問題。
4. Multi-Head Attention 不是「一個 Head 負責文法」
實際語言裡,同一句話可能同時存在很多關係:
- 語法
- 指代
- 主題
- 時間
- 因果
- 語義
- 位置
Multi-Head Attention 讓模型可以在不同 projection / representation subspace 中同時建立多組 Attention 關係。
一個常見但過度簡化的說法是:
Head 1 = 文法
Head 2 = 指代
Head 3 = 因果
不要這樣記。
真實模型內部通常沒有這麼乾淨、固定、可人工命名的分工。
比較安全的理解是:
模型可以同時從多個表示空間觀察序列中的不同關係。
對應用工程師來說,知道到這裡就夠了。
你不需要靠「哪個 Head 在做什麼」來設計產品。
5. Embedding:把文字轉成可以比較的向量表示
Attention 處理的是序列裡位置之間的關係。
Embedding 解決的是另一件事:
怎麼把文字表示成數值向量,讓模型或系統能對語義進行運算。
可以用非常簡化的方式理解:
"apple"
   ↓
[0.21, -0.73, 1.02, ...]
真正的向量通常有很多維,這裡的數字只是示意。
更重要的是:模型內部 representation 會受 context 影響。
例如:
I ate an apple.

Apple released a new device.
同樣的表面文字 apple / Apple,在不同語境下扮演不同角色。
因此不要把 Embedding 想成:
一個單字查一個固定的「AI 字典座標」。
Representation 會隨模型、任務與 context 而變化。
6. 為什麼 Embedding 可以拿來做 Semantic Search?
在應用端,我們常使用專門的 embedding model,把 query、句子、段落或文件映射成向量。
如果模型訓練得適合這個任務,語義較接近的內容通常會在向量空間中更接近。
例如:
A. How can I reset my password?

B. I forgot my login credentials.

C. What's the weather today?
A 和 B 沒有完全相同的字,但意思接近。
Semantic Search 的基本流程可以是:
User Query
    ↓
Embedding Model
    ↓
Query Vector
    ↓
Similarity Search
    ↓
Candidate Passages
這就是 Embedding 在 RAG 裡經常出現的原因。
但這裡一定要避免另一個誤解:
向量很接近 ≠ 文件一定正確。
Embedding similarity 只代表某種表示空間中的接近程度。
它不能保證:
- 文件是最新版本。
- 文件來源可信。
- Chunk 包含完整上下文。
- Top-k 找到真正需要的證據。
- 模型最後會正確使用這些資料。
所以:
Embedding + Vector DB
≠
完整可靠的 RAG
Retriever 只是整條系統的一部分。
7. Attention 和 Embedding 到底差在哪?
如果只留一張表,可以留這張:
| 概念 | 核心問題 | 常見應用直覺 |
|---|---|---|
| Embedding | 這段資訊如何被表示成向量? | 相似度、語義搜尋、分群、retrieval |
| Attention | 在目前序列裡,這個位置應該參考哪些位置? | 動態關係加權、Context 內資訊整合 |
最簡化可以記:
Embedding
= Representation

Attention
= Dynamic relationship weighting
這不是完整數學定義,但可以防止一個常見混淆:
Embedding 不是 Attention,Vector Search 也不是模型在 Context 裡做 Attention。
在典型 RAG 架構中,兩者甚至可能出現在完全不同的階段。
例如:
文件 / Query
    ↓
Embedding
    ↓
Semantic Retrieval
    ↓
相關內容進入 Context
    ↓
LLM / Transformer
    ↓
Attention 處理 Context 中的位置關係
    ↓
生成答案
這條鏈每一層都可能失敗,所以不能只評估最後答案。
8. Attention 為什麼會讓長 Context 有真實成本?
在原始 full self-attention 裡,如果 sequence length 是 n,每個位置需要和其他位置建立 pairwise Attention 關係。
因此 Attention matrix 的規模會隨 sequence length 大約以平方成長:
n ↑

possible pairwise interactions
≈ n²
這就是為什麼長 Context 不只是「API 多收幾個 Token」這麼簡單。
它背後有真實的計算與記憶體成本。
後來出現很多優化。
例如 FlashAttention 的核心貢獻不是把 Attention 改成模糊近似,而是透過 IO-aware tiling 減少 GPU 記憶體層級之間不必要的資料搬移,讓 exact attention 執行得更有效率。
現代模型還可能使用 sliding-window、sparse attention 或其他架構改善特定瓶頸。
所以不要從 O(n²) 直接推導:
「Context 多一倍,API 一定剛好慢四倍。」
實際 latency、價格與記憶體使用還會受到:
- 模型架構
- serving implementation
- hardware
- batching
- cache
- attention implementation
影響。
工程上真正應該留下的是:
Context length 是有成本的系統資源,不是免費容量。
9. KV Cache:為什麼生成下一個 Token 不必每次全部重算?
上一篇已經知道 LLM 是逐 token 生成。
假設模型已經處理:
A B C D
現在要生成下一個 token。
如果每次都把 A、B、C、D 在所有 Attention layer 裡的 Key / Value 全部重新算一遍,會產生大量重複工作。
KV Cache 做的事情就是:
把先前 token 的 Key / Value 保存起來,生成後續 token 時重用。
概念上:
Without KV Cache

A
A B
A B C
A B C D
→ repeatedly recompute prior K/V
With KV Cache

cached K/V for A B C
+
compute new K/V for D
Hugging Face 目前的 Transformers 文件也把 KV Cache 定義為推論階段避免重算過去 Key / Value 的主要機制。
但 Cache 不是免費的。
Context 越長,通常需要保存的 KV 資料也越多。
這會牽涉:
- GPU memory
- concurrency
- batch scheduling
- latency
- serving cost
所以應用工程師不一定要自己實作 KV Cache,但需要知道:
為什麼 Context 長度、生成速度、記憶體與併發量常常是同一個系統問題。
10. 對 AI Application Engineer 來說,這篇真正要留下什麼?
你不需要因為要做 AI Application 就先學會推導 Transformer。
但至少要建立下面這張地圖:
Text
 ↓
Token / Representation
 ↓
Transformer
 ↓
Attention integrates relationships inside context
 ↓
Generation
而在應用外部:
Document / Query
 ↓
Embedding Model
 ↓
Semantic Retrieval
 ↓
Relevant content
 ↓
Context
 ↓
LLM
兩條路會在 AI Application 裡接起來,但它們不是同一件事。
真正值得帶走的是五個判斷:
- Attention 和 Embedding 解決不同問題。
- 資料進 Context,不代表模型一定會有效利用。
- Embedding similarity 不代表事實正確。
- 長 Context 有實際 compute / memory 成本。
- KV Cache 是生成效率機制,不是 Agent Memory。
最後一點尤其重要。
KV Cache 裡的「cache」和我們之後會談的 Agent Memory 完全不是同一層東西。
下一篇會再往應用層走一步:
模型本身是機率生成器,那怎麼把輸出變成程式可以穩定解析與使用的資料?
也就是 Prompt、Structured Output、Tool Calling 和 Sampling 的問題。
來源與驗證範圍
本篇由 Hello-Agents 第三章學習母資料延伸,並於 2026-09-21 重新核對原始 Transformer 論文、FlashAttention 論文、Hugging Face Transformers KV Cache 文件與 semantic search 文件。
本文刻意不做以下主張:
- 不把 2017 年原始 Transformer 當成所有現代 LLM 的完整架構。
- 不把某一種 Attention complexity 直接換算成所有 API 的實際 latency 或價格。
- 不宣稱某個 Attention Head 有固定的人類可解釋職責。
- 不把 Embedding similarity 當成事實正確性。
- 不展開 Vector DB、chunking、reranking、hybrid search 或 embedding benchmark;這些留給後續 RAG 專文。
主要參考:
- Vaswani et al. — Attention Is All You Need
https://arxiv.org/abs/1706.03762 - Dao et al. — FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
https://arxiv.org/abs/2205.14135 - Hugging Face Transformers — Caching / KV Cache
https://huggingface.co/docs/transformers/main/cache_explanation - Sentence Transformers — Semantic Search
https://www.sbert.net/examples/sentence_transformer/applications/semantic-search/README.html - Datawhale / Hello-Agents — 第三章 大語言模型基礎
https://github.com/datawhalechina/hello-agents/blob/main/docs/chapter3/%E7%AC%AC%E4%B8%89%E7%AB%A0%20%E5%A4%A7%E8%AF%AD%E8%A8%80%E6%A8%A1%E5%9E%8B%E5%9F%BA%E7%A1%80.md