Karpathy AI 課程怎麼學?從 micrograd 到 nanochat 的學習路線與先備能力
從基礎運算、文字預測到完整流程,逐步建立可解釋、可檢查的理解。這是本文建議的學習路線示意,非 Karpathy 官方新課綱,也不保證學習成效。
Karpathy AI 課程建議從 Python 與微分基礎開始,再學 micrograd、makemore 與 GPT,最後讀 nanochat。非工程背景可先理解概念,再逐步補齊程式閱讀與除錯能力,不必急著訓練模型。
本文建議的順序是:先確認 Python 與微分基礎,再從 micrograd 理解訓練,接著學 makemore 與 GPT,最後視需求讀 nanochat。 autoresearch 則留給已能判讀實驗結果的人。這是一條依官方教材整理的學習建議,不是 Karpathy 宣布的新課綱,也不是保證轉職的速成班。
Karpathy AI 課程適合零基礎嗎?先分清楚學習目標
Neural Networks: Zero to Hero 從神經網路基礎講起,但第一課已假設讀者具備基本 Python,以及對高中微積分的粗略印象。「從零」指的是逐步建立模型原理,不代表完全不需要程式能力。官方課程說明
非工程背景可以先學概念:資料如何變成數字、模型如何產生預測、為什麼回答流暢仍可能出錯。若目標是親手訓練模型,則建議先確認自己能做到以下幾件事:
- 讀懂 Python 的函式、迴圈、串列與類別。
- 用簡單例子解釋斜率,以及輸入改變時輸出如何跟著變。
- 看懂錯誤訊息,知道程式在哪一行中斷。
- 願意暫停影片重做練習,而不是只追求看完進度。
這份清單是本文的準備建議,不是官方入學門檻。還不熟悉其中幾項,就先補那一項,不必一次學完整本數學課本。
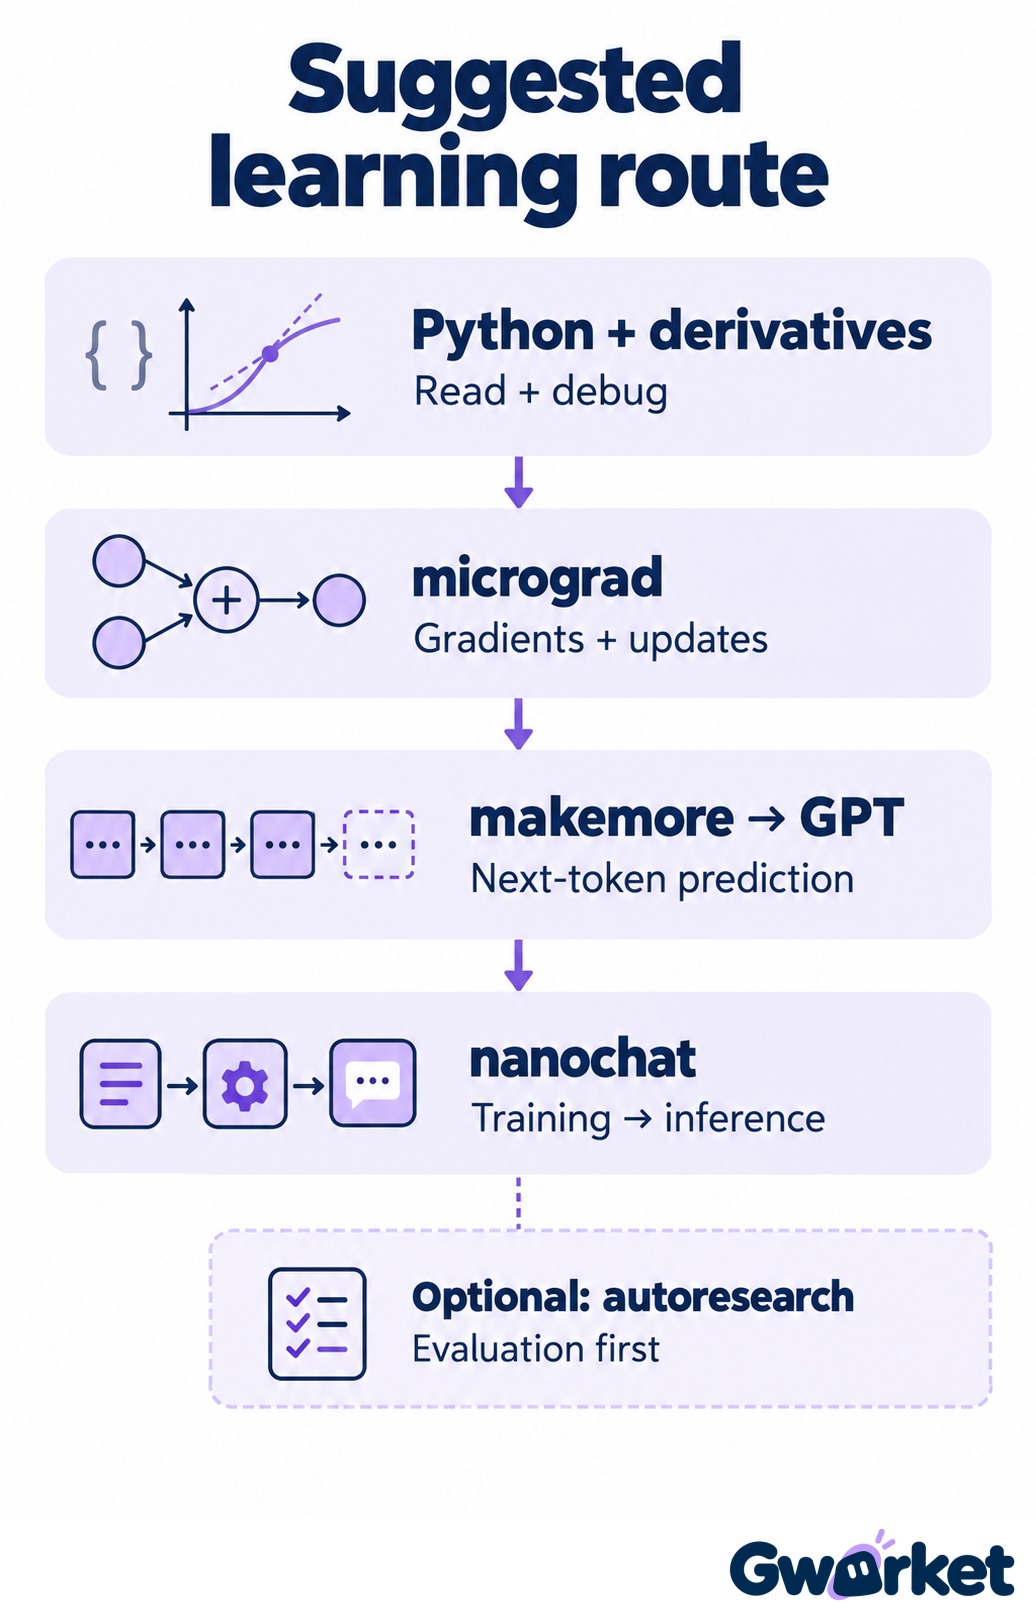
本文章建議先補齊 Python 與微分,再依序理解 micrograd、makemore/GPT 與 nanochat;已有足夠評估能力時,才考慮選修 autoresearch。這不是 Karpathy 官方新課綱,也不保證學習成效。
第一步:用 micrograd 看懂模型為什麼會學習
micrograd 是小型自動微分引擎,讓讀者從純量運算看見計算圖與反向傳播,再把它們組成小型神經網路。它的價值在於程式規模小,方便追蹤每一步運算;官方也明確把教育用途列為定位。micrograd 專案
這一站先回答三個問題:模型的誤差怎麼算?梯度表示什麼?參數如何根據梯度更新?可以拿一個簡單函式,先用紙筆預測改變輸入後的方向,再對照程式結果。
建議的過關標準是:不用背整份程式,也能說明一次「預測、計算誤差、求梯度、更新參數」的流程。如果只會複製執行,先停在這裡補強,比急著進入大型模型更有幫助。
第二步:跟著 makemore 理解語言模型,再進入 GPT
官方課程接著透過 makemore 介紹字元層級語言模型,從簡單的 bigram 延伸到多層感知器,並逐步討論張量、梯度與模型訓練。GPT 教學則建議先熟悉前面的自回歸語言模型與 PyTorch 基礎。Zero to Hero 課程順序
學習時不要只觀察「它有沒有生成文字」。請另外記錄:訓練資料與驗證資料是否分開?誤差下降後,生成結果有什麼變化?改了一個設定,效果能否重現?
到了 GPT 階段,再把注意力放到上下文如何影響下一個 token 的預測,以及 attention 在模型裡扮演什麼角色。此時的成果可以是一份自己的流程圖:文字進來,如何經過模型,最後變成下一步預測。能沿著圖解釋一次,比記住所有術語更重要。
第三步:nanoGPT 還要學嗎?先知道它已被標為 deprecated
不少舊文章會把 nanoGPT 當作下一站,但官方 README 已在 2025 年 11 月註明,專案老舊且已 deprecated,並引導使用者查看 nanochat。nanoGPT 仍保留,可用來對照早期 GPT 模型定義與訓練迴圈;開始新實作時,別把舊教學直接視為目前建議。nanoGPT 官方更新
本文建議:若你正在跟一份使用 nanoGPT 的舊教材,可以把它當閱讀材料;若目標是理解較完整的語言模型流程,下一站優先讀 nanochat。遇到舊指令失效時,先確認教材年代與版本,不要把環境問題誤認成自己沒有學會。
第四步:用 nanochat 串起訓練、評估與對話
nanochat 涵蓋 tokenization、預訓練、微調、評估與推論,適合在理解單個模型之後,觀察各階段如何接起來。官方也提供縮小規模的 CPU/Apple Silicon 範例,但明確提醒,這種方式不會得到強大的模型成果。nanochat 專案
初次閱讀可以先畫出資料與模型檔案的流向,不必立刻租用 GPU。要實際訓練時,再確認硬體需求、執行時間、資料來源與預算上限。專案能產生對話,不代表具備商用聊天服務的品質、安全性或維運能力。
這一站的過關標準,可以設為「說得出每個階段的輸入、輸出,以及怎麼判斷做得好不好」,而不是單憑某一次回答看起來很聰明。
autoresearch 放最後:先學會判讀實驗,才交給代理反覆測試
autoresearch 的 program.md 示範了有邊界的實驗:限定修改 train.py,固定評估方式,單次訓練時間預算為五分鐘,不含啟動與編譯,並先建立基準結果。autoresearch 實驗規範
硬體也要分開看:上游 autoresearch 目前要求單張 NVIDIA GPU,並曾在 H100 上測試;nanochat 的 CPU/MPS 支援不能直接套用到它。autoresearch 平台需求
對學習者來說,值得借用的是實驗紀律:先寫假設、一次控制少數變因、保留紀錄,再比較結果。即使交由代理操作,也應另外設定總預算、可修改範圍與停止條件,保留環境權限和安全限制。單次五分鐘不等於整輪工作只要五分鐘,更不代表可以無限執行。
不同背景,怎麼選自己的起點?
完全沒寫過程式: 先用概念閱讀理解訓練與推論的差別,同時補 Python。第一個目標是看懂 micrograd 的小例子,不必要求自己做出聊天機器人。
會寫程式、沒學過深度學習: 從 micrograd 開始,沿 makemore 到 GPT,練習記錄模型表現。別因為能讀程式,就跳過梯度和驗證資料的用途。
已有模型訓練經驗: 可先讀 nanochat,找出自己不熟的環節,再回頭補課。只有在能檢查評估是否合理後,才考慮 autoresearch 類型的自動化實驗。
選定起點後,下一步只做一件可驗證的小事:手算一次梯度、解釋一筆預測,或畫出一段訓練流程。這條路線的進度,應由你能獨立解釋和檢查的內容決定,不必用收藏了多少專案衡量。
常見問題:一定要買 GPU、每堂課都做完嗎?
沒有 GPU 可以開始嗎? 可以先閱讀教材、手算小例子,以及理解模型流程。不要把購買硬體當成開始學習的前提;等到確定要執行哪個練習,再查該版本的需求。
一定要照順序全部完成嗎? 本文的順序適合建立基礎,也能作為自我檢查表。若已能清楚解釋某一階段,就往後走;一旦發現只能照抄、無法說明結果,就回到缺少的概念。
可以請 AI 幫忙寫練習嗎? 可以用它解釋錯誤或提示下一步,但建議先自己預測結果,再核對答案。最後關掉提示重做一次,才能分辨自己理解了多少。